上周三赶稿到两点,对着对话框敲了半句话,还没按回车,AI直接蹦出来一段戳我的文案。我当时手都顿了。这东西怎么知道我在南京?哦,上周我给它发过三张北京西路的梧桐照片,上次聊天提过一嘴我家离紫金山两公里。
别被”智能”俩字骗了,它根本不知道你在说啥
说实话,我之前跟做算法的朋友在广州路吃鸭血粉丝汤,他啃着鸭肠跟我吐槽,外面吹的那些”AI有自主意识”的鬼话,全是外行瞎传。大模型算法从根上就没有”理解”这个模块。它所有的输出,本质都是个超大型的接话茬高手。
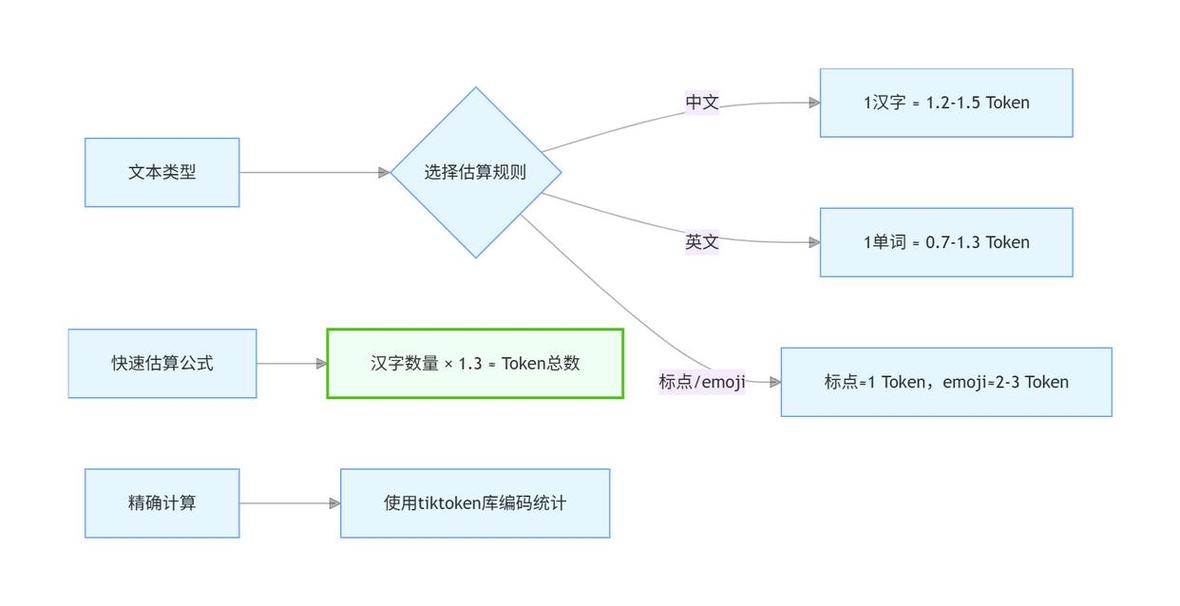
你打出去的每一个字,在它眼里都不是有意义的符号,只是一个个等着被拼进去的小块。它会翻遍自己存的几十万亿字的语料,算出来哪个字跟在你刚打出去的内容后面,出现的次数最多。你打”今天天”,它算出来后面接”气好”的概率是72%,接”黑了”是18%,接”凉了”是9%,剩下1%是各种稀奇古怪的组合。
它不会先停下来想”哦,用户现在在说天气”。
它就是顺着数。
数到哪个概率最高,就先把哪个字蹦到屏幕上。哪有什么读心术,不过是算得比谁都快而已。
那些被吹上天的参数,其实跟你买奶茶的甜度逻辑一样
很多人看到”千亿参数””万亿参数”的说法,第一反应是这东西玄乎到普通人根本摸不透。真的没必要。
你想啊,你常去楼下那家奶茶店,记不记得三分糖放多少糖浆,五分糖要多摇五秒,加珍珠要多等三分钟,芋圆要多掏两块钱。这些你脑子里存着的”对应关系”,放到大模型里就是参数。
参数越多,它记的对应关系就越细。
之前的小模型,看到”我家猫把杯子碰碎了”,大概率只会输出一句”啊呀好可惜”。但参数够多的大模型,能顺着语料里的记忆,接出来”蹲下来看它缩在沙发角装无辜的样子,气都消了一半”。
我上次拿三年前的旧小模型测,让它写一段给自家猫道歉的话,它给我输出了三段标准的”宠物行为引导指南”,看得我差点把手机扔出去。
当然也不是参数堆得越多就越靠谱。就像你记了满脑子的奶茶配方,但是从来没真的站在吧台后面做过奶茶,你照样会把盐当成糖放进去。之前我让大模型算南京到上海的高铁要多久,它张口就说三个半小时。我翻了下购票软件,现在最快的车一个小时47分钟就到了。为啥?因为它存的语料是三年前的旧数据,没跟上现在的线路提速。它根本不知道自己说错了。
别信”替代人类”的鬼话,它连自己说的话都可能不认
现在刷短视频,总能刷到那种危言耸听的内容,说大模型要抢文案、抢设计、抢程序员的饭碗。我每次刷到都忍不住笑。
上次我让大模型帮我算上个月的电费,它列了个长长的公式,把阶梯电价的档位算错了三倍,最后算出来我家一个月电费一千二。我实际交了一百八。
我拿着截图找那个吃粉丝汤的算法朋友,他笑到拍桌子,说这就是大模型的死穴。它算概率的时候,根本不会停下来检查”这个数对不对”。它只是觉得”按照之前见过的语料,写个电费账单的例子,大概是这个数”。至于跟现实对不对得上,它根本不管。
不过话说回来,对吧?你要是真把它当全能助理,那迟早要被坑。我身边有个做设计的朋友,之前用大模型生成活动海报,最后交稿的时候才发现,海报上的联系电话多了三位。客户看了差点把冰美式泼他脸上。
现在好多人追着问,大模型算法未来要发展成啥样,是不是真的要变成有自主意识的数字人。我反倒觉得,没必要把这事想得太玄。
它现在本质就是个超级勤快的实习生。
你让它整理个会议纪要,写个初稿,找个零散的参考资料,它能熬一晚上给你整出来一堆东西,速度比人快十倍。但是你要是真把核心的决策、要对结果负责的事全扔给它,那你迟早要翻车。
比如上次我写梧桐的稿子,大模型给我写了一堆”梧桐大道是南京的城市名片”这种正确的废话。我自己加了一段”去年秋天我在广州路踩了一脚梧桐果,碎掉的汁在白鞋上留了个印,刷了三次都没掉”。最后那篇稿子的评论区,全是说这段写得戳人的。
为啥?
因为那是真的我经历过的事。
不是它从语料里拼出来的、概率最高的句子。
作者|科技
排版|科技
审核|小北