上周六蹲在我家阳台帮我妈导旧照片,她翻到十年前在西湖边拍的糊脸照,随手点了下手机相册的”相似照片”按钮,半秒就跳出来三十多张同时间同地点拍的糊图——甚至有两张是她举着自拍杆没对准焦,只拍到半只西湖醋鱼的废片。她当时愣了,说这玩意儿怎么比我自己还记得我哪天去吃过醋鱼?
你以为它在”思考”,其实它在翻旧错题本
真不是。
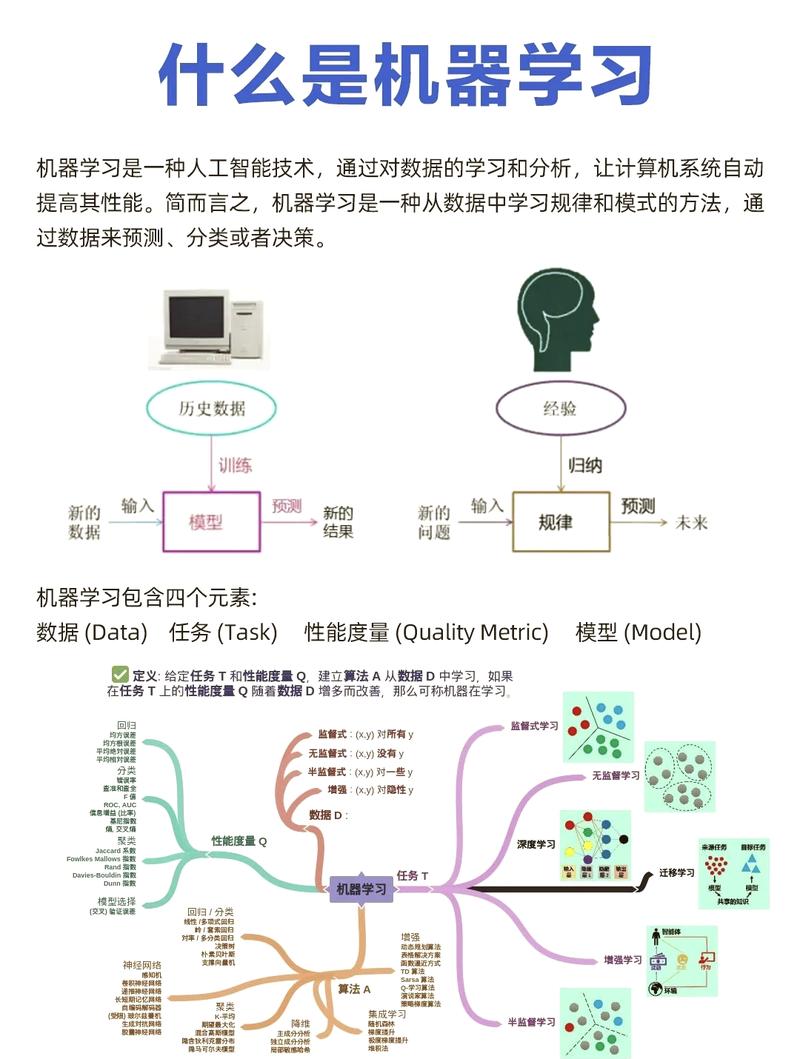
很多人一听到机器学习,就脑补成电脑长出了跟人一样的脑子,能自己琢磨出啥道理,甚至能预判你三年之后的职业选择、你家猫今天会不会拆家,把所有随机发生的事都算得明明白白。
你把它想成一个刚进公司的实习生,笨得很,没有任何先验常识,你给它扔过去一万张标了”猫””狗””糊图””西湖醋鱼”的照片,它就拿着个小破本,每看一张就记下来:哦,带尖耳朵、有胡须的,大概率是猫;边缘模糊、颜色偏黄绿、有鱼刺形状的,大概率是没拍好的醋鱼。
它根本没有对”猫””醋鱼”的本质认知,所有的判断都来自对训练数据里特征关联概率的计算——就像学生做错题本,把每道题的题干特征和正确答案绑死,下次碰到差不多的,就照着之前记的往上套。
我之前见过一个做图像识别的学生,训练模型认猫,一开始模型把所有带沙发的图都判定成猫——因为他给的训练集里,80%的猫都是趴在沙发上拍的。模型哪知道猫本身长啥样啊,它只知道”沙发+软毛”的组合,出现猫标签的概率是92%。你说这是智能?这就是典型的实习生没摸清楚核心规则,把次要特征当标准答案了。
别被”AI幻觉”吓着,它只是没见过的题就瞎蒙
前阵子有个朋友用做简历的机器学习工具,把自己的工作经历输进去,模型给生成的自我评价里写了”精通梵文书法”——给她吓出一身冷汗。她转头找开发者问,对方翻了半天训练日志才发现,训练集里有3%的简历,在”自我评价”那栏,只要写了”跨文化沟通能力强”,后面就跟着梵文相关的经历。
模型哪知道跨文化沟通和梵文有啥关系啊,它只算出来这俩词挨在一起出现的概率高,就顺手给你补上了。
AI幻觉从来不是模型”有意识地撒谎”,只是它碰到了训练集里没覆盖的场景,不敢空着不答,就按照之前记的最高概率的关联硬凑答案。说白了就是实习生碰到没见过的题,不敢交白卷,硬着头皮按照之前记的最像的套路瞎写。你要是给它的训练集里全是北京的路况数据,它给你规划去重庆的路线,能把你导到长江里去——它哪知道重庆有江有桥,单行道比北京多三倍啊。
对,它哪知道啊。
那些吹得神乎其神的”机器学习万能论”,全是没上过手的外行
说实话,我最烦那种把机器学习吹得跟神仙一样的宣传。前两年碰到过一个创业的老板,跟我拍桌子说要做个机器学习系统,能自动判断员工的离职概率,把HR全裁了。我问他你准备拿啥训练?他说就拿之前十年的员工档案,谁走了谁没走,输进去就行。
我当时没好意思直接泼冷水——你知道之前公司走的那批人,一半是因为老板天天画饼,另一半是因为公司楼下的黄焖鸡米饭倒闭了?这些东西你能写到员工档案里吗?模型看不到这些藏在水面下的原因,最后算出来的所谓离职概率,说不定跟员工工位离打印机的距离相关性最高。
机器学习的能力边界,从来不是由算法本身决定的,而是由你喂给它的训练数据的质量、覆盖度决定的。很多人对机器学习的误解,就是觉得只要把数据扔进去,它就能自动挖出所有藏在里面的规律。真不是。你给它的数据本身就带着偏差,它学出来的结果只会把偏差放大一百倍。就像你教小孩认人,你每次见到左撇子就说”这人是坏人”,小孩长大之后见了左撇子就躲——这不是小孩的错,是你教的内容本身就歪了。
上周还有个刚上大学的小孩找我,说自己想转行做算法,问我是不是要把高数全背下来。我说你先别着急背公式,你先拿个公开的小数据集,比如识别手写数字的,自己从头训练一遍模型,看看你给的训练数据少了两成,结果会差多少。他折腾了三天给我发消息,说原来模型把所有带圈的数字都认成0了,因为训练集里0的样本最多。他说原来根本不是书上写的那么回事,什么梯度下降什么反向传播,在他没亲手碰过之前,全是飘在天上的字。
现在好多宣传把机器学习吹成了能替代人的万能工具,好像再过两年连吃饭睡觉都不用自己动手了。但你仔细想想,它从诞生到现在,本质上还是那个攒错题本的实习生——你给它啥题,它就练啥题,你教它啥规则,它就记啥规则。它不会自己突然开窍,也不会突然长出跟人一样的共情能力。上次我妈用相册分类,模型把我家猫的照片跟她跳广场舞的视频分到了一类,她笑了半天,说这电脑还知道我跟猫一样爱晃悠。
你看,它连晃悠的是猫还是人都分不清楚,哪来的那么多魔法啊。
作者|科技
排版|科技
审核|见微