他半瓶冰可乐下肚就开始吐槽,说现在外面把大模型算法传得跟能通灵似的,什么都能算。上周有个做文创的朋友找过来,问能不能把他们家存了十年的老顾客留言全喂给模型,自动生成能精准戳中每个老粉的定制贺卡,算下来成本比雇三个文案还低,转头发现喂进去的东西一半是门店收的手写便签照片,连个清晰的文字识别都没做。
大模型算法根本不会“想”
很多人对大模型的第一印象,是它能写文章、能写代码、能跟你聊哲学,肯定是像人一样有思考能力的。
真不是。
你每次跟大模型聊天,打出去的每一个字,在它那里走的流程,跟你小学时候做的英语完形填空没本质区别——就是猜下一个位置上最可能出现的词是什么。整个大模型算法的核心逻辑,到今天为止都没跳出“逐字猜概率”的框架。你打出去“今天天气真好,我们一起去”,它会把所有可能接在后面的词算一遍出现的概率:“逛”占32%,“爬山”28%,“吃饭”22%,剩下的零散分布在“看海”“打球”这类词上。它就顺着概率从高到低排,凑成一句读着顺的话输出给你。
就这么简单。
之前有人说大模型会写古诗是因为它懂文学审美,其实你把它的输出拆到最细的计算层,会发现它连“诗是什么”都不知道。它只是读了几千万首前人写的诗,知道哪些字挨在一起出现的频率更高,拼出来的东西刚好符合你对“诗”的印象而已。你要是给它喂进去一堆“床前明月光,玻璃好上霜”这种打油诗,它写出来的东西也会跟着变味,根本不存在什么独立的审美判断。
被吹上天的“算法优化”,一半是在做“断舍离”
很多人觉得,算法越优化越厉害,就是堆更多参数、喂更多数据,搞更复杂的数学公式。
说实话,一半是对的,一半是错的。
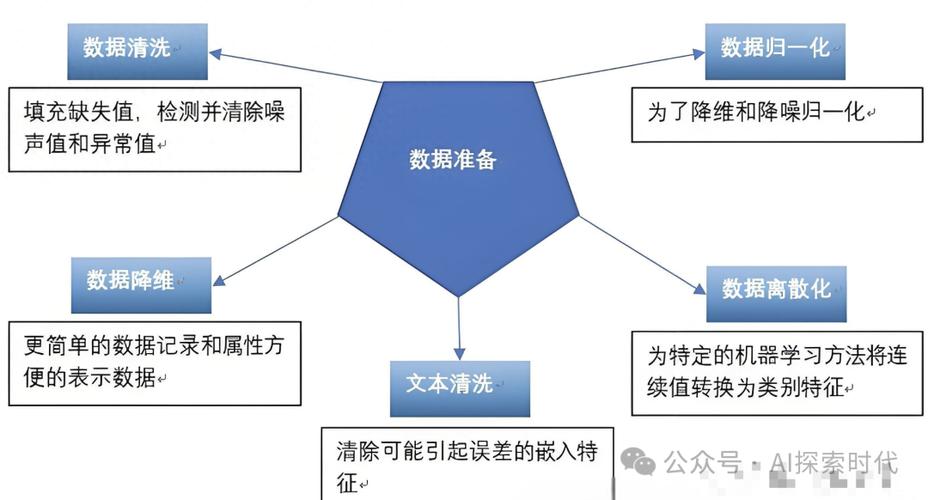
我那同学说,最早的大模型训练的时候,100G的原始爬取数据里,差不多30G是没用的垃圾:弹窗广告、乱码的网页碎片、重复的爬虫快照,甚至还有不少网站的隐私政策文本。这些东西喂进去,模型学不到有效信息就算了,还会学歪——比如一被问问题就输出一段版权声明。现在很多算法团队的日常,一半时间在调参数,另一半时间在跟训练数据里的垃圾打架。去年某开源模型上线前,整个团队花了整整两周,把训练集里所有无意义的辱骂语料、重复的广告文本全清出去,不然模型一被触发就会输出莫名其妙的脏话。
听着挺蠢的。
但就是这种看起来上不了台面的脏活,占了整个模型开发流程差不多60%的工作量。外面写的科普文总把算法塑造成飘在天上的黑科技,实际上大部分时候,工程师跟在垃圾数据后面擦屁股的时间,比写核心计算逻辑的时间多得多。哪有那么多灵光一闪的天才创意,大部分优化都是一点点抠细节抠出来的。
别把大模型算法当万能钥匙
上次撸串到一半,他手机响了,是个开水果店的老学长找过来,问能不能搞个大模型算法,自动算每天进多少草莓、多少车厘子,把货架损耗降到最低。
他当时差点把手里的烤筋掉桌上。
跟老学长解释了十分钟,说真用大模型算进货量,还不如你在店里站三个月摸出来的经验准。为什么?大模型是靠海量公开数据训练出来的,它知道全国范围内水果进货的大概规律,但它不知道你家店门口上个月修地铁,人流少了三分之一,也不知道你家隔壁开了个小学,下午四点接孩子的家长会顺路买两斤橘子。大模型算法最擅长的事,是处理那些“有海量公开共性数据”的问题——比如写通用文案、总结公开文档、写标准格式的代码。这些东西网上有几亿份现成的材料可以学,它猜出来的结果大概率不会太离谱。
但它处理不了那些高度个性化、没有共性数据的事。比如你家猫今天为什么突然把桌上的杯子推下去,比如你家三亩茶园今年能出多少斤明前茶,比如你家楼下便利店每周几要补多少货。这些事你就算把全网的数据都喂给它,它算出来的结果也不如你自己天天在现场摸出来的经验准。
不过话说回来,现在很多人对大模型算法的期待,本来就有点歪。总觉得这是个能一劳永逸的神器,只要把东西喂进去,就能躺着把钱赚了。我见过太多团队,上来就砸几百万搞大模型落地,最后发现自己的业务流程根本没捋顺,存了好几年的数据一半是乱码,把模型架上去之后输出的东西全是错的,最后钱花了啥效果没有,反过来骂大模型算法是骗子。
真不是算法的问题。
是他们自己从一开始就没想明白,到底要拿这个工具解决什么问题。
作者|科技
排版|科技
审核|安然