 大讲堂

按当时的峰值算,每秒流失的GMV够一家中型创业公司活一整年。
事后复盘的结果特别讽刺:他们提前三周就做了所谓的“全链路压测”,从网关到业务层全跑通了,所有指标都显示系统能扛住平时5倍的流量。最后出问题的节点,是他们压测时根本没覆盖到的、给支付接口做风控校验的一个第三方外部服务——那家伙的阈值只设到了平时流量的1.2倍,真到峰值直接被打挂,连带把自家的支付链路也堵死了。
别把全链路压测当“大促专属演练”
很多团队对全链路压测的认知,还停留在“大促前拉个群,跑个流量测测服务器扛不扛得住”的阶段。
这根本不算全链路。
真正的全链路,要从用户端的APP启动、CDN资源加载、DNS解析、负载均衡分发、每一层业务服务的调用、缓存命中、数据库读写、消息队列异步削峰,一直延伸到所有和核心交易相关的外部依赖——支付渠道、风控接口、物流查询、短信通知,甚至是给用户发优惠券的营销系统。少了任何一个环节,压测出来的结果都是自欺欺人。
见过太多公司砸钱买了几十万的压测工具,拉着团队熬了好几个通宵,最后压测报告做得漂漂亮亮,真到上量的时候掉链子。去年有个做社区团购的客户跟我吐槽,他们压测的时候把所有内部服务都压到了设计峰值,结果真到团长开团的高峰,优惠券核销的老接口因为日志输出没做限流,写满了磁盘的inode,整个服务直接卡死,从发现问题到恢复花了两个多小时,当天的开团流量直接掉了4成。
你说亏不亏?

技术边界:到底什么才算真的“全”
真的全链路压测,从来不是把生产流量放大10倍那么简单。
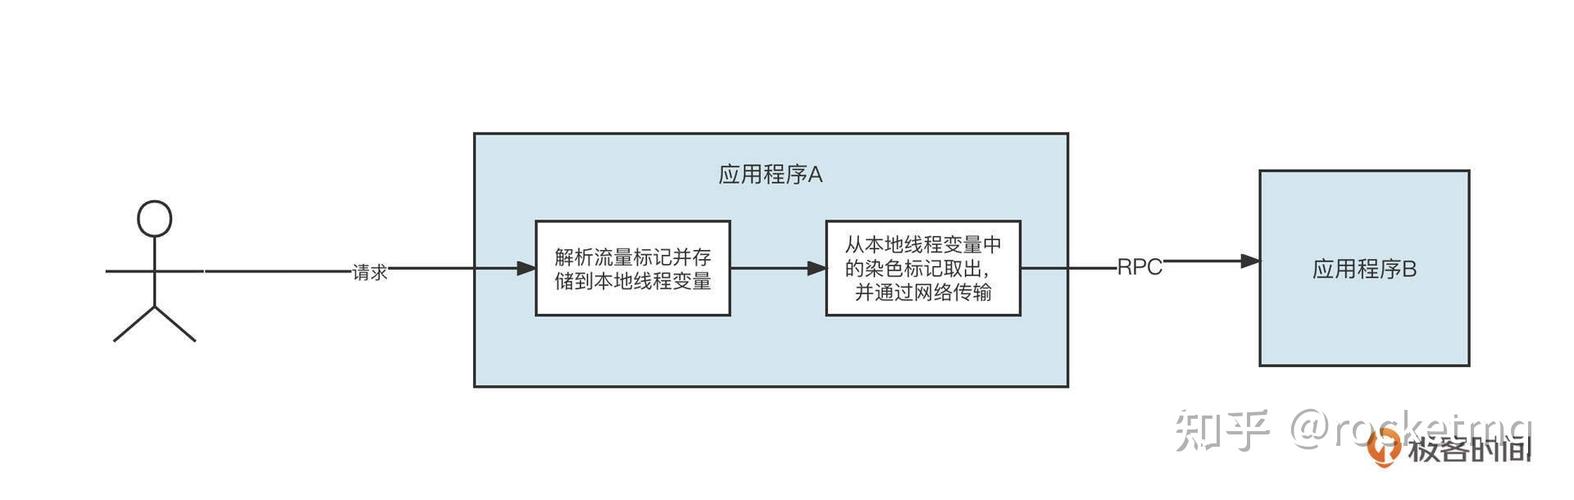
行业里最早做全链路压测的那批互联网团队,最早走的弯路就是拿测试环境凑数。测试环境的服务器配置只有生产的三分之一,网络拓扑也和生产完全不一样,连个独立的分库分表实例都没有,压出来的容量数据根本没有参考价值。后来大家摸出了一套可行的方案:直接在生产环境做压测,靠“流量染色”技术给所有压测流量打一个特殊的标记,让链路里的每一个节点都能识别出这是压测流量,不会把它当成真实的用户请求处理。
说起来简单,做起来全是坑。
比如压测的订单数据,必须在数据库层面做物理隔离,不能混到真实的订单表里,不然压测结束一删数据,真实用户的订单也被删了,那就是天大的事故。比如压测流量打到第三方的支付接口,不能真的发起真实扣款,得跟第三方提前报备,让他们把对应的压测请求拦截下来,返回模拟的成功结果,不然压一次就产生几十万笔真实交易,财务那边的账根本对不平。
别信那些厂商吹的“零侵入全链路压测”。
零侵入个鬼。
光给每个业务服务的入口加流量识别的过滤器,就得拉着研发团队改至少两轮代码,更别说要把压测流量和真实流量在缓存、消息队列、数据库层面完全隔离,稍有不慎就是生产级的故障。
行业现状:一半的团队在“演压测”
现在做全链路压测的玩家大概分三类。
第一类是互联网大厂内部磨出来的自研工具。比如阿里从2012年双11开始攒的那套压测体系,经过十几年大促的打磨,基本是行业里的标杆,但这套工具从来没对外开源,只给阿里云的高等级付费客户做定制化交付。第二类是从传统性能测试转型的第三方厂商,最早靠卖LoadRunner这类单机压测工具起家,现在也开始做全链路的方案,但大多还是停留在模拟内部流量的阶段,对外部依赖的覆盖很弱。第三类是云厂商自带的压测服务,胜在和自家的云资源打通,配置起来方便,但定制化能力不足,很难适配不同行业的复杂业务链路。
跟行业里的人聊下来,大概有6成的中大型企业,所谓的全链路压测其实就是“演”给老板看的。压测的时候把流量集中打到网关层,看着QPS数字涨得很漂亮,根本没往后端的核心依赖打。去年有个做直播电商的团队,压测报告写着系统能扛每秒10万的请求,结果真到头部主播带货的时候,第三方的物流查询接口只能扛每秒2000请求,直接把整个下单链路堵死,用户付完款看不到物流状态,客诉量半天就涨了三倍。
说白了,很多团队做全链路压测,不是为了真的找系统瓶颈,是为了在大促的项目汇报会上,能拿出一个“我们已经做了充分准备”的证据。
压测本身的风险:别为了测系统把系统测崩了
全链路压测从来不是一个没有风险的技术动作。
见过最离谱的一次事故,是某银行的科技团队做核心系统压测,没配流量熔断的阈值,压测流量直接把生产的核心交易数据库打挂了,整个网点的柜面系统停了快两个小时,最后被监管约谈。还有的团队压测流量没做好隔离,压出来的假订单直接流到了仓储系统,仓库的物流小哥真的把货发出去了,最后光退货成本就赔了上百万。
真的,经历过一次这种事,你就会明白,压测的时候手心冒汗是什么感觉。
现在整个行业其实还没有统一的压测安全标准。不同行业的容错阈值完全不一样:互联网公司的压测可能允许系统有10%以内的性能波动,金融行业的核心系统压测,甚至要提前跟监管报备,严格控制压测的时间和流量规模,不能影响真实用户的交易。很多中小团队根本没意识到这个问题,上来就往生产环境打流量,出了事才后悔。
说点实在的,接下来3-5年,全链路压测的定位会彻底变。
不会再是每年大促前才做一次的专项演练。
它会变成云原生时代,企业系统韧性的基础能力。就像人每天要量血压测心率,不用等到心梗发作才往医院跑,常态化的全链路压测,会把系统的瓶颈在平时就找出来,不用等到流量峰值的时候临时救火。
接下来你会看到几个很明显的趋势:
第一,全链路压测会和混沌工程深度结合。不再只测正常状态下的峰值能力,压测的时候会故意切断某个机房的网络,杀掉某个核心服务的实例,甚至模拟第三方接口的超时,看整个系统能不能在异常状态下扛住峰值流量。
第二,压测的边界会从企业内部的服务,延伸到整个产业链的外部依赖。以前大家只测自己家的系统,以后会把合作的支付渠道、物流接口、甚至供应链的系统都纳入压测范围,不然自己的系统扛得住,合作方扛不住,照样出问题。
第三,会出现专门的压测安全服务。毕竟不是每个团队都有能力把流量隔离、熔断、回滚的机制做完善,未来会有专门的厂商帮企业做压测前的风险评估,压测中的流量控制,压测后的问题复盘,把压测的风险降到最低。
没人想在大促的零点,盯着监控屏幕看着接口报错率往上涨。
毕竟那种感觉,比熬夜赶方案糟糕一百倍。
作者|fawen
排版|fawen
审核|满满