 大讲堂

他在那管一个超算分中心的运维。
刚坐下来他就灌了半杯冰可乐,说上周刚给某药企跑完一个分子模拟的任务,算到一半机房的精密空调跳了,整整停了11个小时。那堆攒了三个月的实验数据,差一点就全废了。
你说讽刺不?
我们现在天天喊数字经济,算力是核心生产要素,结果最顶级的算力集群,连个稳定的供电供冷都能卡得死死的。很多人对高性能计算的认知还停留在“国之重器”的宣传海报里,觉得那是离普通人十万八千里的东西,直到自己的项目因为算力不够卡壳,或者交了几十万的算力服务费发现根本跑不出预期的结果,才反应过来,这东西的水,比想象中深得多。
别把普通服务器集群当高性能计算:技术边界根本不是堆机器
很多企业老板张口就说自己建了“高性能算力中心”,拉回来几百台GPU服务器,把网线一插,就算成了。
错得离谱。
高性能计算的核心从来不是单颗芯片的峰值算力有多高,是把成千上万颗计算单元的通信延迟压到微秒级的能力。一颗GPU每秒能算100万亿次,但是它算完的结果要传给下一颗GPU,要是传的速度比算的速度慢1000倍,那这一整个集群的实际有效算力,可能还不如单颗卡的一半。

之前碰到一个做工业仿真的创业团队,老板上来就拍胸脯说他们的集群有12P的算力,比隔壁省超算中心的对外服务算力还高。结果拉了技术细节一看,所有GPU之间连的都是普通商用以太网,没有专用的高速互联网络,跑汽车碰撞仿真的时候,通信开销占了总算力消耗的60%,实际能用到的有效算力,连标称值的2成都不到。花了两千万买的设备,最后成了个昂贵的摆设。
真要论技术边界,高性能计算和普通服务器集群的区别,就像专业短跑运动员和平时在小区里跑步的人的区别——看着都是跑步,实际的能力差了好几个量级。国家层面的顶级超算,要把几十万颗核心的通信延迟压到1微秒以内,才能在气象模拟、天体物理计算这类需要全局同步的任务里跑出精度;而普通的企业服务器集群,连不同机架之间的通信延迟都在几十微秒以上,根本接不住需要大规模并行的计算任务。
现在的高性能计算生态,卡在三个没人明说的坎上
聊到行业现状,做了十几年超算运维的朋友最常说的一句话是:现在的热闹,大多是给资本市场看的。
第一个坎,是软硬件适配的断层。
不管是进口的GPU还是国产的算力芯片,参数表上的峰值算力都漂亮得不行,但是一跑实际的行业软件,就露馅了。汽车行业用了三十年的LS-DYNA,生物领域常用的GROMACS,这些经过几十年迭代的行业核心软件,最初都是基于x86架构和特定的CUDA生态写的,换一套芯片架构,就要逐行改代码、做适配,成本高到离谱。之前听某国产芯片厂商的技术负责人吐槽,他们给某高校的超算中心供了一批高性能计算卡,本来以为能跑出80%以上的有效算力,结果人家的科研软件都是在CUDA上写了十几年的,前后花了三个月的时间做移植优化,最后只跑出了标称算力的35%。
这谁的问题?
都不是。生态的账,从来不是靠砸钱、抢项目能短期补上的。
第二个坎,是算力利用率低到离谱。
行业里有个公开的秘密,国内大部分商用超算中心的平均算力利用率,连30%都到不了。为啥?因为算力的供需根本没打通。建超算的人,只知道把机器堆在机房里等着客户上门;需要算力的小课题组、创业团队,根本不知道去哪找匹配自己任务的算力,就算找到了,也不知道怎么把自己的代码优化到能在大规模集群上跑。
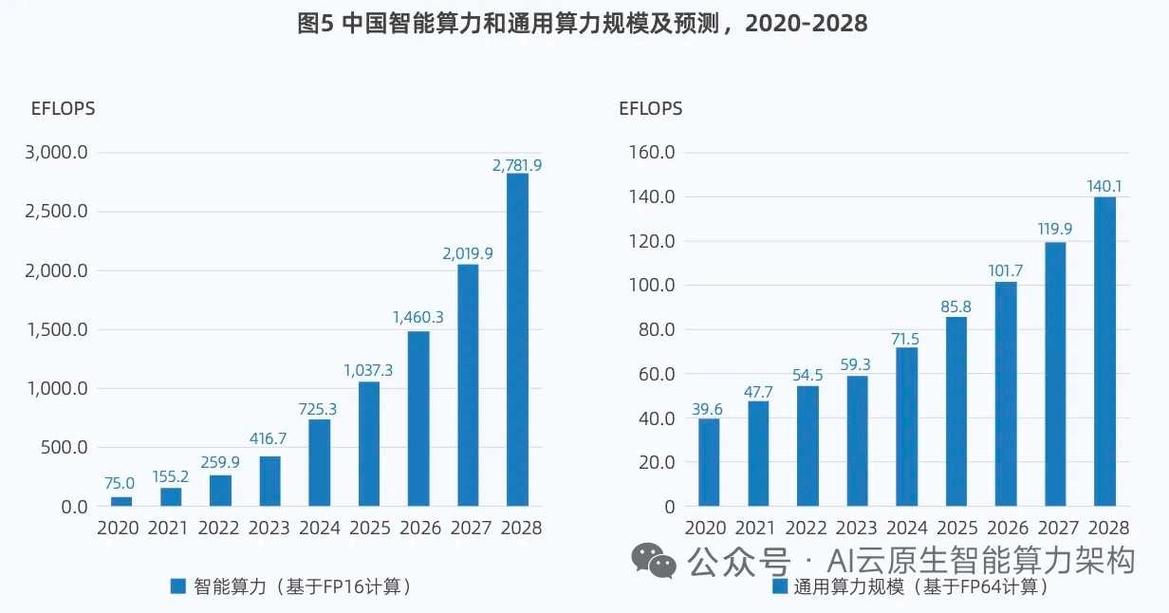
更有意思的是,很多地方为了抢“全国算力枢纽节点”的名头,拍脑袋批地建机房,机器买了一堆,结果根本没有匹配的产业场景,最后只能靠低价接一些没有技术含量的渲染单来回本,算来算去,连每年的电费都赚不回来。
第三个坎,是供冷供电的硬成本。
别笑,这真不是小事。现在一台顶级的AI高性能服务器,满载功率能到3千瓦,一个100P算力的集群,光满载功率就有1.5兆瓦,加上配套的制冷系统,一年的电费就能顶得上一个中型制造工厂的全年利润。去年夏天华东地区限电的时候,苏州有个超算中心停了整整三天,接的几个航天仿真订单,赔了快两百万的违约金。上周那个管运维的朋友说,他们现在花了小两百万装了一套备用柴油发电机,就怕夏天再碰到断电的事。
别只盯着算力卡的竞争:产业链的影响已经渗透到了制造业的骨子里

很多人觉得高性能计算离普通人很远,其实根本不是。
你开的燃油车或者电动车,在正式上市之前要做几百次碰撞安全测试。以前没有高性能计算的时候,要造几百辆真车撞,一次碰撞实验的成本就有几十万,现在用超算做高精度的碰撞仿真,一次仿真的成本可能只有几千块,算出来的结果精度还能达到物理实验的95%以上。这省下来的研发成本,最后不就是车价的让利空间?
还有创新药研发。以前找一个能和致病靶点精准结合的候选分子,要在实验室里做几万次合成实验,往往花个五六年都找不到合适的方向,现在用超算做分子动力学模拟,能把候选分子的范围从几万压缩到几十个,新药研发的整体周期能从10年缩到6年,研发成本能砍近一半。去年碰到一个做肺癌创新药的团队,他们之前在实验室筛了三年都没找到有效候选化合物,后来把所有已知的分子结构放到超算上跑了两周的模拟,直接筛出来3个候选分子,现在已经进入临床一期了。
你说这高性能计算到底值多少钱?
根本算不出来。
现在全球的高性能计算竞争,早就不是比谁的超算在TOP500排行榜上排的名次高了。一套完整的高性能计算生态,从底层的高速互联网络、算力芯片,到中间的并行计算调度系统,再到上层的行业专用软件,每一个环节的话语权,都决定了未来硬科技领域的竞争主动权。目前全球的成熟生态基本是美国主导的,从芯片、网络到软件的标准都是人家定的;我们这边的国产生态,现在虽然还没到能完全替代的程度,但是已经在气象模拟、工业仿真这些对自主可控要求极高的场景里跑通了全流程,有效算力已经能追平国际一流水平。
当然,这里面也藏着不少容易被忽略的风险。
现在很多地方把建超算中心当成了捞政绩的工具,拍脑袋上大项目,最后造成的算力资源浪费,本质上是对公共财政的消耗。还有更隐蔽的数据安全问题——现在用超算跑的任务,很多是药企的核心分子结构、汽车厂的核心碰撞参数,甚至是航天领域的关键仿真数据,这些数据要是在算力流转的过程中泄露了,损失根本没法估量。之前有个行业调研说,近4成的中小算力用户,根本没和算力服务商签过正式的数据保密协议,就把自己的核心代码和数据传上去跑了。
心是真大。
聊到未来3-5年的行业走向,那个做了十几年运维的朋友的判断很实在:
首先,大家拼的再也不是谁的峰值算力数字好看,是谁的有效算力更高。你标称的10P算力,实际能给用户跑出8P的可用算力,那不管你用的是进口卡还是国产卡,你就能拿到最多的订单。那些天天喊着要建EFLOPS级超算的地方,先把自己机房的PUE值降到1.3以下,把算力利用率提到50%以上,再说后面的事。不然建得越大,亏得越多。
其次,超算不会全部集中在西部的大型算力枢纽里。靠近产业园区的小型模块化超算,会比千里之外的大枢纽更受欢迎——毕竟把几十TB的仿真数据从东部传到西部,光传输的延迟和带宽成本,算下来根本不划算。
最后,国产算力生态不会一上来就追求全栈替代。它会先在几个软件生态相对开放的垂直领域跑通,比如气象、工业仿真、生物计算,把有效算力提上去,把适配成本降下来,慢慢攒用户的口碑,再往其他领域渗透。
说到底,高性能计算从来不是什么飘在天上的概念。它就是实打实的生产工具,工具好不好用,从来不是看宣传册上的数字,是看跑任务的时候稳不稳,成本够不够低。
作者|fawen
排版|fawen
审核|知知