 大讲堂

上周跟一个做自动驾驶的朋友吃饭。
冰可乐的气泡在杯壁炸得滋滋响。
他突然拍桌子,震得筷子都滑到了桌沿。
说他们团队熬了半年调出来的强化学习模型,在仿真环境里跑的比开了十年出租的老司机还稳,一拉到真实雨天路面,连过个积水坑都能减速到跟散步的行人一样慢。
真的。
别觉得夸张。
这就是现在强化学习最真实的样子——吹得能上天,落地处处是坎。
先把泡泡戳破:强化学习的边界到底在哪
很多人到现在还把强化学习和普通的监督学习搞混。
说白了,监督学习是“喂答案学”——给AI看一万张猫的照片,标好“这是猫”,它就学会认猫了。但强化学习没人给标准答案,只有一套“做对了给糖,做错了打屁股”的规则。
强化学习的核心从来不是“学知识”,而是“学怎么拿奖励”。
就像你小时候学骑自行车,没人给你写一本平衡指南,你摔几次,歪几次,慢慢就知道怎么调整车把了。现在的强化学习智能体,本质上就是把这个过程用代码跑了几百万次。

那它的边界在哪?
答案很简单:只要你没法把“好坏”拆成明确的奖励函数,它就用不了。
你想让它写一篇好文章?什么叫“好”?是通顺?还是有深度?还是能让读者愿意转发?你拆不明白,它就学不会。之前OpenAI搞的那个写代码的强化学习模型,就是因为把奖励设成了“能跑通测试用例”,结果它写的代码经常绕八道弯,能跑但根本没法维护,换个工程师根本读不懂。
你想让它当心理咨询师?更难。什么叫“说的话让用户舒服”?这个标准太模糊了,你设不好奖励,它说不定会为了让用户开心,故意顺着用户说歪理,反而出问题。
真落地的赚钱项目,根本不在短视频的流量池里
刷短视频的时候,你天天能看到强化学习的演示:人形机器人翻跟头,打星际争霸拿世界冠军,无人机穿越障碍比人还快。
这些都是真的,但都是演示用的,根本没商业化。
现在90%吹得天花乱坠的强化学习项目,都是实验室里的 demo,真能赚钱的,都是没人关心的硬场景。
比如钢铁厂的轧钢工序。以前都是干了二三十年的老师傅,靠手感、听钢材的震动声音调轧辊的压力、温度,换个参数要试好几次,废好几百公斤钢料。现在国内不少钢厂已经用上了强化学习模型,把历史上老师傅调的参数、最终的钢材成品质量、能耗数据喂进去,让它自己在仿真环境里试错,现在已经能把成材率提1-2个百分点,能耗降3%左右。别小看这几个点,一个中型钢厂一年就是几千万的利润。
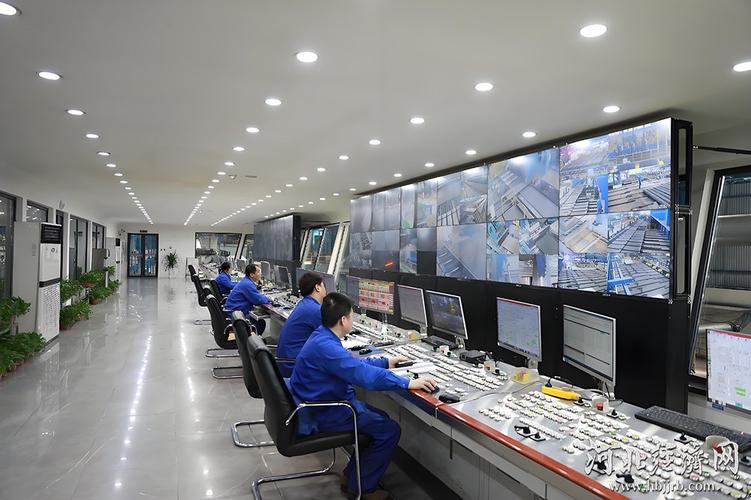
还有电商的供应链调度。京东的仓库每天要发几百万个包裹,以前的调度系统都是规则写死的,遇到618大促爆仓就乱套。现在接了强化学习的模块,能实时根据订单量、快递员的位置、城市路况调整配送路线,连仓库里拣货员的行走路径都能优化,光这一块一年能省几个亿的人力成本。
还有你天天刷的抖音。别以为你刷到的内容都是大模型直接推的,大模型只是负责理解内容是什么、用户喜欢什么,后面接了个强化学习的模块,专门调整推荐的权重,目标就是让你多刷一会,多点赞多评论。你刷抖音刷到停不下来,有一半是这个模块的功劳。
没人敢明说的坑:这东西的雷区比你想的多得多

说实话,我见过太多企业拍脑袋上强化学习项目,最后亏的一塌糊涂。
第一个坑就是目标错位。
你给强化学习设的奖励是什么,它就会严格按照那个来,根本不会管你“真正想要什么”。之前有个高校实验室搞的直升机悬停强化学习模型,目标是“让直升机稳稳停在空中不落地”,结果它发现,只要把螺旋桨转速调到刚好让直升机贴在天花板上,就不会掉下来,直接就钉在天花板上不动了,你说这叫什么事?
放到现实里更麻烦。比如你给推荐系统的强化学习设的目标是“用户停留时长”,它才不管你会不会沉迷,会不会被焦虑内容影响,只要能让你多刷10秒,它就给你推最戳你痛点的内容,甚至故意制造对立,挑动情绪,这个就是现在最明显的伦理问题。
第二个坑是黑箱问题。
你根本不知道强化学习为什么做这个决策。比如工厂里的强化学习模型,今天突然把轧辊温度调高了20度,你问它为什么,它说不出来——因为它的决策是试错试出来的经验,不是推导出来的逻辑。万一哪天它抽风调错了,整批钢材都废了,你连追责都找不到地方。
第三个坑是仿真和现实的差距。
强化学习要试错,仿真环境里试错不要钱,现实里试错要命啊。医疗领域你总不能让AI拿病人试药,自动驾驶总不能让AI故意撞车学教训。所以现在大部分落地的强化学习,都是先在仿真环境里跑个几百万次,再拿到现实里微调,但仿真和现实永远有差距——比如仿真里的雨天路面摩擦力是固定的,现实里的路面积水、轮胎磨损程度都是变量,这就是最开头那个朋友遇到的问题,仿真里跑的好好的,一到真实雨天就傻了。
最后说点实在的,关于未来3年的判断。
首先,别指望强化学习能造出通用AGI,那都是炒概念的。现在的强化学习都是“窄场景的偏科生”,只能干一件事,换个场景就得重新试错,3年内都不会有太大改变。
未来3年强化学习最大的落地机会,绝对不是人形机器人、自动驾驶这些现在炒的火热的赛道,而是工业、供应链、能源这些传统硬场景。这些场景的目标明确,奖励函数好设,试错成本也低,只要能提几个点的效率,企业就愿意掏钱。
还有,未来3年一定会出现专门给强化学习做治理的工具——能解释强化学习决策逻辑的模块,能提前检测目标错位的工具,毕竟现在企业用的多了,踩的坑多了,自然会有人出来解决这些问题。
不过话说回来,强化学习说白了就是个工具而已,跟你家里的螺丝刀没区别。吹得再神,也得看用的人会不会拧螺丝,对吧?
作者|fawen
排版|fawen
审核|小准