 大讲堂

2018年那会,随便一个DL创业公司,拿个跑通Demo的PPT就能融几千万。路演的时候张嘴就是“通用人工智能”“颠覆所有行业”。现在?没人吹了。
被吹过头的DL,到底边界在哪?
很多人对DL的认知还停留在“什么都能做”的阶段,甚至把大模型的能力等同于DL的全部。但说白了,DL的本质是基于海量标注数据的模式拟合,而非具备自主推理能力的通用智能。
你给它喂一百万张标注好的猫的照片,它能精准认出猫。但你要是给它看个披着猫皮的柯基,它大概率会给你输出“置信度98%,猫”的结果。更别说那些需要因果推理的场景——比如你问它“为什么打疫苗能防新冠”,它能给你编出一套听起来很合理的回答,但它根本不知道“免疫应答”到底是怎么回事。
之前有个做医疗影像DL的团队,拿了三甲医院的几十万张肺炎X光片训练模型,实验室里准确率能到97%。结果拿到基层卫生院去测,准确率直接掉到62%。为啥?模型学的根本不是肺炎的影像特征,是三甲医院CT设备的成像噪点特征。基层设备的成像参数不一样,模型直接懵了。
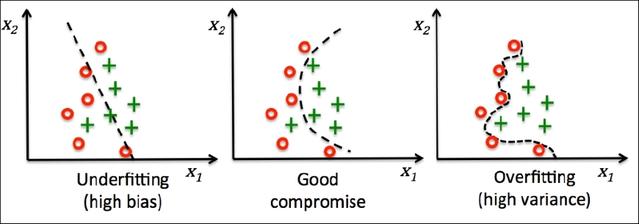
这就是DL最核心的边界:它的能力上限完全由训练数据的分布决定,只要输入数据超出了训练集的范围,再贵的GPU也救不了。现在很多人说要突破DL的瓶颈,搞小样本学习、零样本学习,说白了就是想让模型不用喂那么多数据也能干活,但直到现在,这些技术还停留在实验室阶段,离大规模落地还差得远。
现在DL的落地,全在啃硬骨头
2023年大模型火的时候,所有人都觉得DL的下一个风口是通用聊天机器人。但真到了落地的时候才发现,To C的场景烧钱太快,用户留存率低到可怜,反而那些之前没人看得上的垂直场景,才是DL真正能赚钱的地方。
之前跟那个做工业质检的创业者聊,他说他们现在做的玻璃瑕疵检测,之前厂里用人工质检,一个工人一天看8小时,眼睛看花了漏检率能到15%。他们的DL模型刚装上去的时候,因为车间的光线不稳定,有时候阳光斜照进来,玻璃反光,模型就把反光当成了瑕疵,漏检率甚至比人工还高。后来他们花了三个月,给每个车间装了统一的冷白补光灯,还专门收集了不同光线、不同批次玻璃的上万张标注图,才把准确率拉到了99.2%,比人工高了一大截。
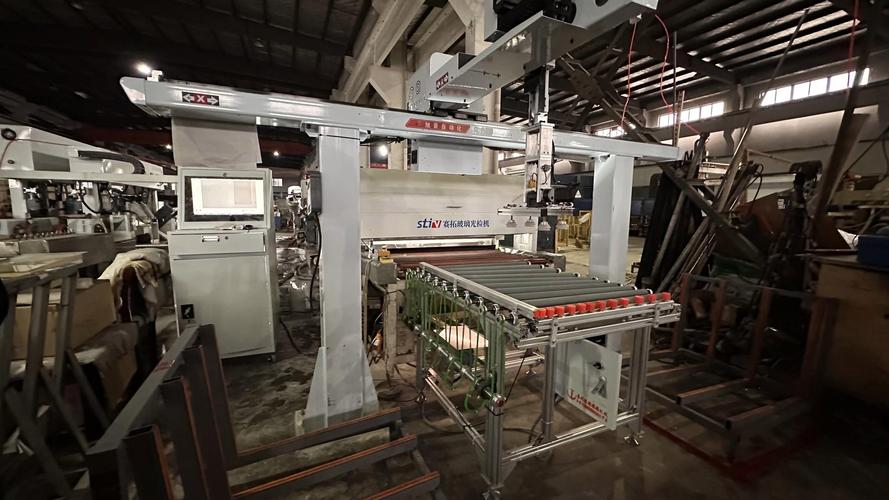
现在DL落地的核心成本,已经不是模型训练的钱了——开源的大模型随便就能下,微调一下就能用。真正的成本是场景适配:你得跑到客户的车间里,测不同的光线、不同的设备参数,收集符合场景的标注数据,甚至还要跟客户的现有生产系统做对接。之前那个做教育题库的创业者说,他们本来以为用DL识别学生的手写错题很简单,结果发现不同学生的笔迹差太多,还有的学生写的字歪歪扭扭,甚至在题旁边画小人,模型识别准确率上不去,后来只能加了个人工复核的前置环节,成本直接涨了两倍,利润薄得像纸。
现在整个DL产业链的格局也变了。上游的GPU厂商之前卖芯片赚得盆满钵满,现在大家都在搞模型压缩、边缘端部署,很多场景根本不用跑在云端的大芯片上,一个指甲盖大小的边缘AI芯片就能搞定。中游的模型服务商也从之前的“卖通用模型”变成了“卖定制化解决方案”,下游的客户也越来越理性,不会再为那些花里胡哨的Demo买单,只问你能帮我省多少钱,赚多少钱。
DL的风险,从来不是什么“取代人类”
每次聊到DL的风险,总有人跳出来说“AI要统治人类了”“以后人类都要失业了”。说实话,这些都是科幻电影看多了的臆想。真正的DL风险,全是落地过程中实实在在的问题。
第一个就是数据隐私。DL要训练模型,就得喂大量的用户数据。之前有个做个性化推荐的DL团队,为了提高模型准确率,偷偷爬了用户的手机通讯录、浏览记录、甚至外卖订单数据,连用户喜欢吃辣还是吃甜都知道,最后被监管罚了几千万。还有那些做面部识别的DL公司,之前到处在小区、商场装摄像头,收集人脸数据,根本没经过用户同意,现在都被要求整改了。
第二个是算法歧视。之前有个国外的公司用DL做招聘筛选,训练数据用的是过去十年的员工简历,结果模型给女性候选人的打分会自动低20%,为啥?因为过去十年公司招的员工里男性占了80%,模型就默认“优秀候选人都是男性”。这种歧视不是故意的,是训练数据里带的偏见,模型自己会学出来。现在国内的金融场景也开始用DL做风控,要是模型学了之前的贷款数据里的地域偏见,给某个地区的用户自动拒贷,那问题就大了。
还有一个更隐蔽的风险,就是人的能力退化。现在很多医生开始依赖DL的病理切片初筛,要是哪天模型出错了,医生会不会因为太信任模型,直接漏诊?还有现在的司机用自动驾驶的DL功能,时间长了会不会连方向盘都不会打了?这些问题现在还没有明确的解决方案。
最后说说未来3-5年的判断。
首先,通用大模型的参数竞赛肯定会停。现在训练一个千亿参数的大模型要花几十亿人民币,除了几家头部的互联网公司,根本没人玩得起。接下来的重点是模型的轻量化,把大模型压缩到能跑在手机、边缘设备上的大小,不用联网也能用。
然后,DL的落地会彻底告别Demo阶段,进入ROI优先的时代。之前那些拿个Demo就想融资的公司,现在要么死掉,要么转去做垂直场景的落地。比如工业质检、电网巡检、农业病虫害识别这些场景,只要能帮客户降本增效,就有愿意买单的,而不是那种虚头巴脑的通用场景。
最后,监管规则会越来越细。比如DL模型的训练数据必须溯源,不能随便爬用户的隐私数据;比如金融、医疗这些敏感场景的DL模型,必须具备可解释性,不能给用户一个“模型算出来的”理由就完事。
上周跟那三个创业者聊到天黑,做工业质检的那个说,现在他们的模型已经在江苏的三家玻璃厂落地了,虽然踩了无数坑,但每个月能给客户省十几万的人力成本,客户愿意续费用。他说,以前大家觉得DL是万能的,现在才知道,DL就是个工具,跟一百年前的电、五十年前的计算机一样,你得把它放到合适的场景里,磨掉所有的毛刺,才能真正用起来。
作者|大讲堂
排版|大讲堂
审核|小准