 大讲堂

拆碎数仓的懒汉逻辑:维度表的核心边界到底在哪
先破个误区。很多人觉得维度表就是Kimball星型模型里的那个“小表”,跟事实表放一起凑个模型而已。错。 维度表的本质,是把所有用来“描述事物属性”的信息,从用来“记录交易行为”的事实表里完全剥离。说穿了,事实表记的是“2024年11月11日,用户A在上海静安区的门店买了一支199元的口红”,而维度表记的是“用户A是25岁女性,常住上海静安区,偏好彩妆;这支口红是2024年秋季款,属于彩妆类目,进货价80元;上海静安区的门店是一级渠道,店长是张三”。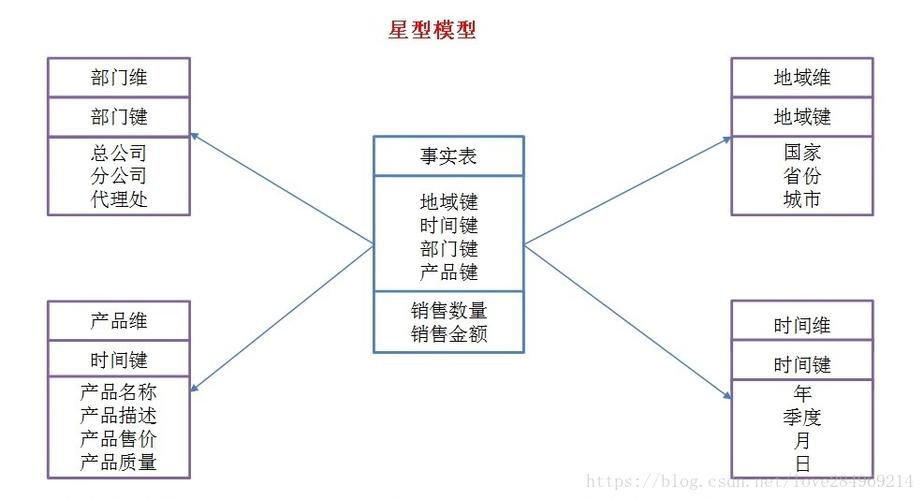
云厂商的财报暗线:维度表赛道的产业化现状
别觉得这是小打小闹。你去翻Snowflake、阿里云、AWS最近两年的技术发布会,一半的数仓性能优化,都是围着维度表转的。 去年Snowflake发Hyperdrive引擎的时候,专门加了个维度表常驻内存的缓存机制。为什么?因为他们统计了平台上1200家头部客户的查询日志,发现82%的查询性能瓶颈,根本不在事实表的扫描上,而在维度表的关联环节。很多客户的维度表更新不及时,每次查询都要重新拉全量维度数据做join,光这一步就占了90%的查询耗时。
没人愿意捅破的雷:维度表落地的隐形治理风险
吹了这么多好处,也得说点踩过的坑。 第一个坑,就是维度爆炸。很多企业做精细化运营做疯了,恨不得给每个用户加几百个细粒度标签,最后维度表的体积从几个G涨到几个T,每次关联的时候,光加载维度表就要花几十秒。之前有个美妆客户,给用户维度表加了172个标签,从“是否喜欢哑光口红”到“是否对花粉过敏”全有,我当时看着他们的维度表头都大了——你说记录用户消费偏好就算了,连用户是不是左撇子都要存,这对销售分析有什么用?最后跑一个用户分层的查询,要花12分钟,比之前的大宽表还慢。 第二个坑,是维度的一致性问题。这个坑踩的人最多。比如销售部门的区域维度表,把华东区域定义为上海、江苏、浙江;运营部门的区域维度表,把安徽、福建也算进华东。最后两边的月度销售数据差了12个亿,开周会的时候拍桌子吵了俩小时,才发现是维度表的定义不一样。我见过最离谱的,同一个企业有6个不同版本的“用户等级”维度表,从普通用户到钻石用户的划分标准,每个部门都不一样。 还有更要命的,是隐私合规的问题。现在的维度表,存的全是用户的敏感标签——比如“有高血压病史”“单亲家庭”“月收入低于5000”。之前某互联网公司的维度表被拖库,里面的用户标签全被泄露,最后被罚了几个亿。很多企业根本没意识到,维度表不是普通的数仓表,里面存的是最细粒度的用户画像,一旦出问题,就是合规大事故。 我接触了上百家做数据基建的团队,还有几个云厂商的核心产品经理,聊下来有几个很明确的判断: 首先,未来2年,维度表的设计会完全自动化。现在的团队还要手动拆事实表和维度表,未来AI会自动根据你的查询习惯,帮你拆分表结构,自动优化维度表的关联逻辑,甚至自动清理没用的冗余标签。到时候根本不用你懂什么星型模型,AI会把所有脏活累活干了。 然后,未来3年,会出现专门做维度表治理的垂直工具。现在的BI工具、数仓工具,根本解决不了维度一致性的问题——你总不能每次开周会之前,先拉三个部门的人对一遍维度定义吧?未来的工具会给每个维度表加版本号,每个部门用的哪个版本的维度表,数据口径是什么,一目了然,再也不会出现两边数据对不上的闹剧。 最后,未来5年,维度表会从数仓延伸到所有实时决策场景。比如自动驾驶的车端系统,事实表存的是实时的车速、车距、传感器数据,维度表存的是实时的天气、路况、周围车辆的属性,然后毫秒级给车发指令;比如智慧工厂的生产系统,事实表存的是设备的实时运转数据,维度表存的是设备的参数、原材料的批次、质检的标准,实时调整生产流程。 哦对,别觉得这是天方夜谭。现在已经有车企在做类似的尝试了。 很多人觉得数据基建就是砸钱买服务器、上云,搞个几百TB的存储就完事了。根本不知道真正的效率提升,往往藏在这些没人注意的小细节里。 维度表从来不是什么高深的学术理论。它就是把复杂的事情拆简单了——把描述的和交易的分开,把统一口径的维度单独存起来,别乱七八糟堆在一块。 就这么简单。作者|大讲堂
排版|大讲堂
审核|阿辰