 大讲堂

上个月跟某新消费品牌的数据负责人在写字楼楼下的咖啡店碰了面,他刚跟业务部门吵完架,眼睛里都是红血丝。说花了三百万搭的数仓,现在业务部门天天投诉,查个上周的直播活动ROI要等四十分钟,报出来的数还跟财务的对不上,两边差了快20%。
很多人一听到数仓出问题,第一反应是“技术不行”“算力不够”,其实根本不是。90%的数仓故障,根源都能追溯到最开始的建模环节——从根上就没搭对,后面再怎么加算力、写优化脚本,都是补窟窿。
那些被算错的账:数仓建模的真实生存边界
别信那些培训机构吹的“学会三范式、维度建模就能当月薪两万”的鬼话。数仓建模的核心从来不是把数据存进去,而是让跨部门、跨时间维度的数,能在同一个语义下被算对。
早年某头部电商搞618大促的时候,商品部算的“活动转化”是用户点了商品链接就算,运营部算的是用户提交订单才算,两边对着报表拍桌子的时候,没人想起当初建模的时候,根本没在公共层把这个指标的定义锁死。最后整个大促的复盘会,光对齐指标口径就花了整整一下午。
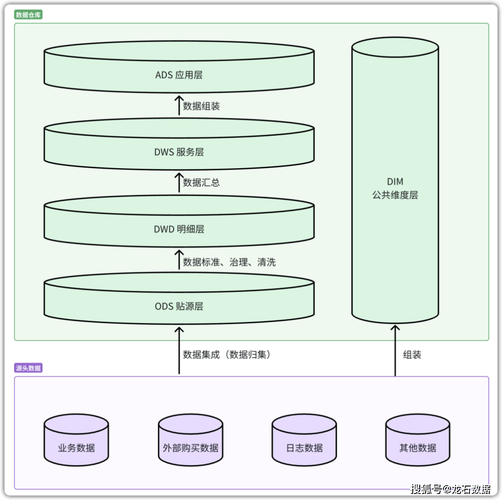
说穿了,数仓建模的技术边界其实非常清晰:它解决不了业务流程的混乱,也替代不了业务团队的决策,它能做的,就是把散落在各个业务系统里的、格式乱七八糟的原始数据,按照统一的规则清洗、汇总,变成全公司所有人都能看懂、能溯源、不会算错的公共数据资产。超出这个边界的问题,再厉害的建模师也救不了。
行业已经卷到什么程度:从“分层建模”到“语义层下沉”的关键转折
最早大家对数仓建模的认知,基本都来自Kimball那套经典的维度建模理论,跟着Teradata、Oracle这些传统数仓一起长了快三十年。前几年云数仓起来的时候,行业里甚至出现过“建模已死”的论调——反正存算分离,弹性扩容,随便查都快,费那劲搭分层模型干嘛?
结果真跑了两三年,大家集体被现实打了脸。数据量涨得比算力降价的速度还快,不少公司一年光云存储的账单就涨了60%,查询速度倒是快了,可业务部门要的数还是不对。为什么?因为没有统一的建模规则,每个数据开发写的SQL都是自己的逻辑,同个指标在不同的报表里能算出三四个完全不一样的数。
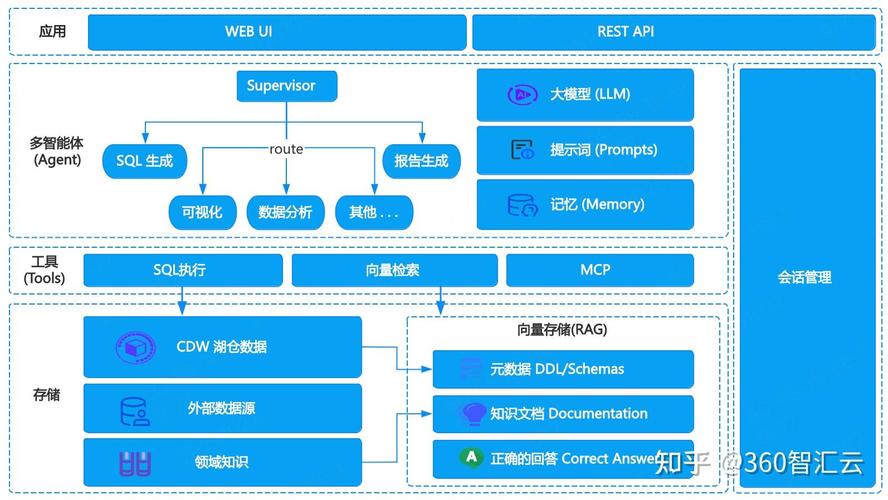
这两年行业的风向彻底转了。现在头部玩家的共识是,公共层的指标定义和权限,从数据团队手里,往业务侧的语义层下沉了。不管是阿里的OneData、字节的DataLeap,还是国外的dbt、Cube这些工具,本质上都是在解决同一个问题:把数仓建模里最容易出矛盾的指标口径部分,从零散的SQL脚本里抽出来,变成全公司所有人都能看到、能溯源的公共资产。
说实话,这事儿说起来简单,做起来能掉三层皮。我之前见过一个公司,光是把“月活用户”的定义从二十多个版本收敛到一个统一口径,前后就开了三个月的对齐会。销售部说要算产生过成交的客户,产品部说要算打开过App的用户,客服部说要算提过工单的用户,最后拍板的时候,数据团队的人差点在会上哭出来。
产业链的隐形洗牌:建模能力正在变成数仓厂商的核心护城河
之前数仓厂商拼的是什么?是单节点算力多少,存储成本多少,复杂查询的响应速度多少,比的全是底层的硬件参数。现在不对了。
你仔细观察就会发现,现在主流云数仓的底层技术差距,其实已经拉不开了。Snowflake和BigQuery的查询速度差多少?普通业务用户根本感知不出来。真正能让客户愿意续费、愿意从竞品那边迁移过来的,是你能不能帮客户把建模的成本降下来。
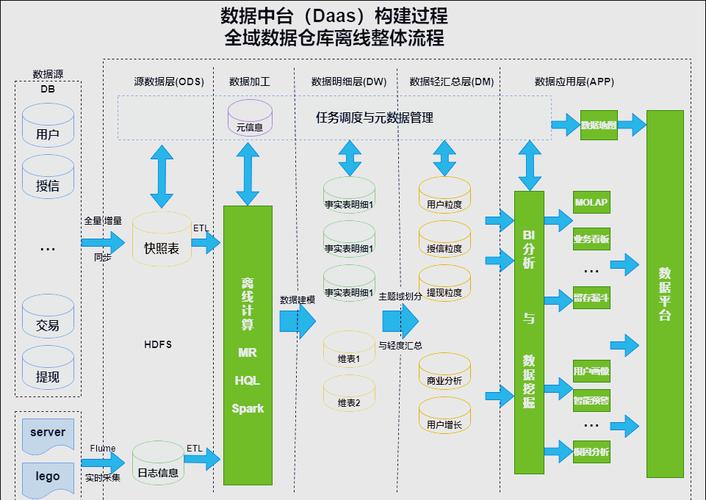
国内现在做云数仓的玩家,从阿里云的MaxCompute,到腾讯云的CDW,再到一堆做开源数仓的创业公司,最近这一年全在往自己的产品里塞建模相关的功能。什么自动识别业务维度、自动生成DWD层的清洗规则、自动给全链路指标打血缘标签——说白了,就是想把原来需要数据开发花几个月干的建模脏活累活,用工具给自动化了。
这根本不是什么技术迭代。这是赤裸裸的商业竞争。原来客户买数仓,是买个“装数据的仓库”,现在客户买数仓,是买个“能直接出正确业务数的工具”。谁能把建模的门槛打下来,谁就能抢下那些原来养不起几十人数据团队的中小客户。
被忽略的治理陷阱:建模不是越细越好
很多团队一开始做数仓建模,很容易走极端。恨不得把每个业务场景的维度都拆得明明白白,建了几百张表,结果跑了半年,发现一半的表根本没人用,光维护这些表的成本,就占了数据团队60%的精力。
我真的见过太多个这种走弯路的团队。一开始对标大厂的数仓架构,照着抄分层,抄指标体系,抄到最后发现自己公司一年的GMV还没大厂半天的流水高,搞那么细的建模根本就是资源浪费。还有的更离谱,为了追求所谓的“模型灵活性”,把三范式用到极致,结果查个数据要连七八张表,性能差到业务部门根本不想用。
数仓建模的本质是平衡——在查询效率、存储成本、口径统一三者之间找最适合自己业务规模的平衡点,而不是拿行业最佳实践当标准答案。对,这是病,得治。刚起步的创业公司,一共三个数据开发,搞什么复杂的语义层?先把最核心的几个交易、用户指标的口径锁死,别等业务跑起来了数都对不上,比什么都强。
未来三到五年,数仓建模这个领域,肯定会有三个非常明确的变化。
第一,建模的工具化会进一步下沉。现在很多需要资深数据开发花几个礼拜才能搭完的公共层模型,未来1-2年大概率会被大模型+自动化建模工具覆盖。你只要把业务的表结构、指标需求喂给工具,它就能自动生成符合规范的DWD层清洗逻辑、DWS层的汇总模型,甚至能自动识别出哪些表是冗余的,哪些指标是重复的。到那个时候,数据开发的核心竞争力,就不再是写SQL搭模型的能力,而是跟业务对齐口径、设计指标体系的能力。谁用谁知道。
第二,行业会出现明确的分层。头部的大公司,还是会有自己的专业建模团队,搭自己的私有数仓,毕竟数据安全、定制化的需求摆在那。但占市场90%以上的中小客户,根本不会再花钱养专门的建模团队,直接买带内置建模能力的云数仓SaaS就行。就像现在没人自己搭机房买服务器一样,未来也不会有多少中小公司自己从零开始搭数仓模型。
第三,会有新的行业标准出来。现在的数仓建模,说白了还是每个公司自己玩自己的,你家的“客单价”定义跟我家的根本不一样。但随着跨公司的数据流通越来越多,比如供应链上下游的数仓打通,品牌方和渠道方的数据对账,未来肯定会出现一套通用的、被全行业认可的指标建模标准——就像当年的会计记账准则一样,不管你是开餐厅还是做电商,算利润的逻辑都是统一的。
说穿了,别把数仓建模想得多高深。它本质上就是给全公司的人搭一个共同算账的账本。账算对了,业务才能跑明白。就这么简单。
作者|大讲堂
排版|大讲堂
审核|安然