 大讲堂

上周跟一个做连锁零售的CIO在楼下撸串,他拍着大腿吐槽,三年前花了小一千万搭的所谓‘新一代数仓’,现在连个实时的全渠道用户复购率都算不出来——每次要数,技术部都要熬两个通宵跑批,老板等得都快把桌子掀了。
这事不是个例。
很多人对数据仓库的印象,还停留在二十年前Oracle时代的‘大号数据库’,觉得这东西早就过时了,被什么大数据平台、湖仓、大模型替代了。
但真扎进产业里看就会发现,过去三年所有落地的AI应用,几乎没有一个能绕开数据仓库。
数仓不是存数据的仓库,是企业的业务记账本
很多人对数仓的误解,从名字就开始了。
你以为它是个存数据的仓库?错。
它本质上是把企业散落在各个系统里的‘碎账’,整理成一本能看懂、能算账的总账本。
你平时用的交易系统、客服系统、门店POS系统、小程序后台,都是各自记各自的流水——交易系统记你付了多少钱,客服系统记你打了几次投诉电话,POS系统记你在门店刷了会员卡。这些数据单独看都没用,拼到一起,才是一个用户的完整画像,才是企业能用来做决策的依据。
数仓的核心逻辑从来不是‘存’,是业务建模——按业务的主题,把数据清洗、对齐、关联起来。比如同样是‘活跃用户’,数仓里会统一成‘30天内有过至少一次有效交易行为的用户’,不管你是在小程序下的单,还是在门店付的钱,都会被归到同一个维度里,不会出现各个部门报的数对不上的尴尬情况。
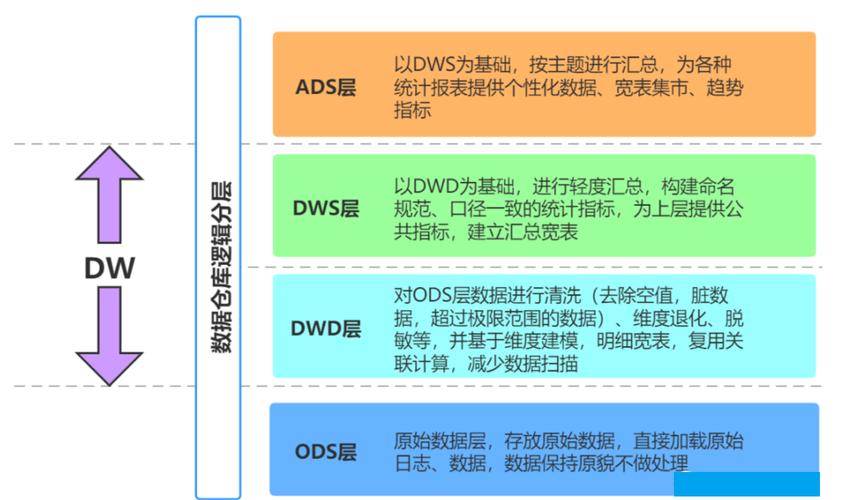
说起来轻巧,做起来能把人逼疯。
我见过最离谱的一家公司,光对接业务系统就用了八个月——客服系统里的用户ID是微信openid,APP端的是设备ID哈希,门店POS的是会员卡号,连‘订单完成’的定义都不一样:物流系统里是用户签收,交易系统里是商家确认收款,客服系统里是用户没在7天内申请退款。
要是没有数仓把这些乱七八糟的规则统一了,各个部门报上来的数能差出30%。
很多老板花几百万买了最贵的数据库软件,最后数仓做成了垃圾场,本质上就是把数仓当成了存数据的地方,根本没做业务建模——你往里堆再多原始数据,也算不出有用的数。
从T+1到秒级:过去五年数仓的三次迭代
最早的数仓,是典型的‘T+1模式’——每天半夜业务量最低的时候,才把各个系统的前一天的数据抽出来,清洗、跑批,第二天早上才能看到昨天的数。
那时候的数仓,就是给老板做月度、季度报表用的,慢一点也没关系。
但后来业务节奏变了。
直播带货要实时看哪个商品的转化率高,线下门店要实时调库存,甚至连投流都要实时看ROI,等你第二天才看到数,钱都花完了。
这就倒逼数仓从离线往实时走。
第一次迭代是实时数仓的普及:原来要跑几个小时的批处理,现在能做到秒级出数。比如你现在刷抖音,刷到的广告为什么刚好是你昨天搜过的商品?背后就是实时数仓在毫秒级里把你的浏览行为、历史偏好、商品库的库存情况算出来,给你推的。
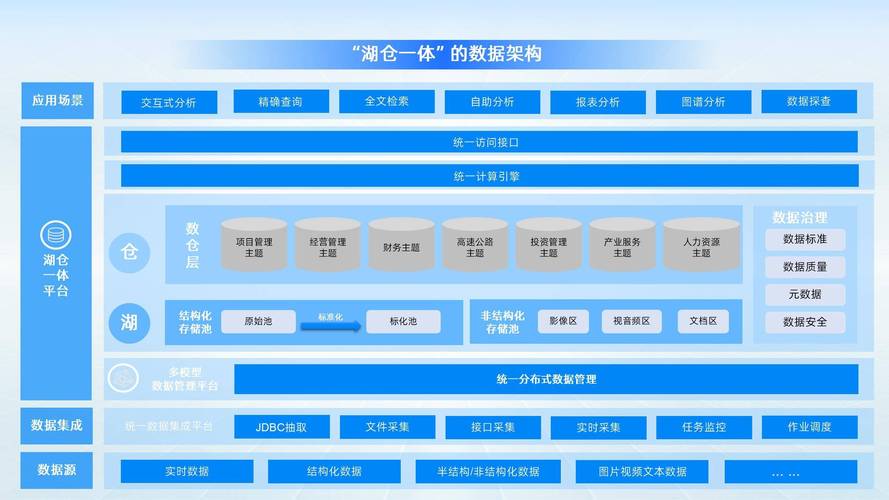
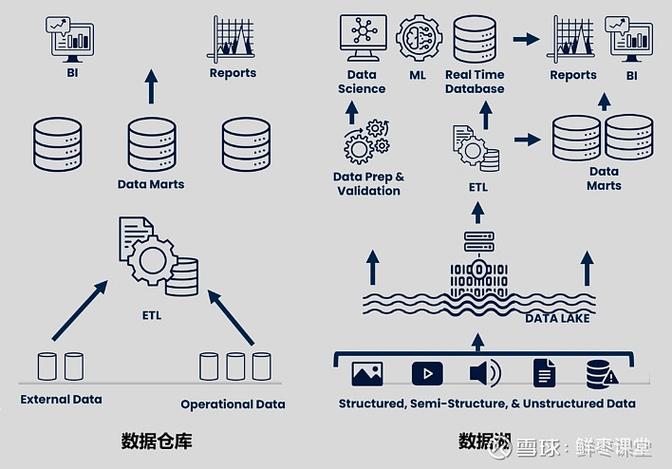
第二次迭代是湖仓一体的出现。原来的数仓只能存结构化数据——就是能塞进表格里的数,比如订单金额、用户ID。但现在企业要分析的东西越来越多:用户在小红书发的种草笔记、客服的录音、门店的监控视频,这些非结构化数据原来的数仓根本存不了,更别说分析了。湖仓一体就是把原来数仓的结构化存储,和大数据平台的非结构化存储打通,不用再把数据搬来搬去。
现在国内的数仓赛道,早就不是Oracle一家独大的时代了。云厂商的托管数仓占了大半份额:阿里的MaxCompute,字节的ByteHouse,还有AWS的Redshift,都在抢企业客户。
不过话说回来,很多厂商吹的‘湖仓一体替代所有传统数仓’,纯属营销话术。
我去年接触的一家快消公司,刚花两百万上了某头部云厂商的湖仓,结果跑个季度的经销商库存周转分析,比原来用了五年的老数仓还慢三个小时。为啥?他们的数仓团队上来就把所有数据往湖里堆,连最基本的分区、分桶都没做,能快才怪。你说这钱花得冤不冤?
数仓从来不是买个软件就能用好的——工具只是基础,背后的建模规范、数据治理能力,才是核心。
AI来了,数仓反而成了最抢手的基础设施
很多人说大模型出来之后,数仓就没用了,大模型直接就能从原始数据里找答案。
扯淡。
我去了不下十家做私有化大模型的企业,没有一家是直接把原始业务数据喂给大模型的——先不说原始数据里有多少敏感信息,光是数据不对齐,大模型算出来的数就能错得离谱。
比如你问大模型‘上个月华东区的销售额是多少’,要是没有数仓先把华东区的门店定义、订单的有效状态、退款的规则统一了,大模型能给你算出三个不同的数。
现在越来越多的企业发现,私有化大模型要落地,第一步不是买GPU,是先把自己的数仓搭好。
大模型要的是干净、结构化、权限清晰的业务数据,这些东西只有数仓能提供。
举个真实的例子:某连锁茶饮品牌,去年搭了基于数仓的智能分析平台,把所有的原料出库数据、门店制作单、报废记录都串起来,跑了一遍才发现,有三家门店的奶盖报废率比平均水平高42%——查下来是店长故意把还能用的原料算成报废,转手卖出去套钱。
这种事,你靠大模型直接从原始数据里挖,根本挖不出来。
除了给大模型供数据,数仓现在还在往业务的前端走。原来的数仓是后台部门用的,现在销售、运营、门店店长,都能直接从数仓里拉自己需要的数,不用再找数据部提需求等三天。
说白了,数仓的价值从来不是存了多少数据,是能帮业务少踩多少坑,少花多少冤枉钱。
数仓的坑,从来不是技术的坑
不过现在数仓的问题也不少。
最突出的就是‘数据垃圾场’的问题。很多公司的数仓里,存了七八年的历史数据,连个权限都没有,光存储成本一年就大几百万。还有的数据权限乱开,之前某互联网公司的数仓管理员,能随便导出所有用户的手机号,转手卖了几十万,最后闹到了监管部门。
还有个更隐蔽的问题:很多公司的数仓做不好,根本不是技术不行,是部门墙太厚。业务部觉得数仓是技术部的事,不愿意把自己的核心数据交出来,最后数仓里的都是边角料数据,做出来的分析根本没用。
未来三到五年,数仓的三个确定趋势
站在现在的时间点往未来看,数仓的发展其实已经很清晰了。
第一个判断:数仓不会被任何新技术替代,反而会成为AI落地的核心底座。以后所有的企业级AI应用,不管是智能客服还是销售预测,都得跑在数仓上面——没有干净的业务数据,再强的大模型也是空中楼阁。
第二个判断:实时数仓会成为标配。T+1的数仓会慢慢被淘汰,毕竟现在的业务节奏,等你第二天看到数,黄花菜都凉了。以后的数仓,从业务数据产生的那一刻起,就会被清洗、建模,实时给业务部门出数。
第三个判断:中小公司不会再自己搭数仓了。以前只有大公司养得起几百人的数仓团队,以后中小公司直接用云厂商的托管数仓,按用量付费就行,不用再自己养技术团队。
上周跟那个吐槽数仓的零售CIO又撸串,他说现在已经把原来的老数仓拆了,换了云厂商的托管实时数仓,现在老板要数,五分钟就能出来,再也不用熬通宵了。
你看,数仓这东西,从来不是什么高大上的黑科技,就是帮企业把账算明白的工具。
只要企业还要算账,数仓就永远不会过时。
作者|大讲堂
排版|大讲堂
审核|见微