2026-10-14 06:27:57 作者:大讲堂
上周在杭州的一场产业闭门会,我蹲在会场后排啃汉堡的时候,听见两个做To B销售的哥们在吐槽。说上个月给某制造企业推的多模态质检方案,演示的时候惊为天人,真把模型拉到车间跑三天,错漏率直接飙到20%以上。
客户拍桌子骂人的时候,他们俩站在旁边,连辩解的话都找不到。
所谓“多模态”,根本不是把文字、图片、音频拼到一起那么简单
很多人对多模态的理解,还停留在“大模型能看图、能听声音、能输出文字”的层面。
错了。
现在90%对外宣传的“多模态大模型”,本质是单模态模型的串联拼接——图像识别模块先把照片转成一段文字描述,音频识别模块先把录音转成文字稿,再把这些文字一股脑塞给纯文本大模型,让它输出回答。整个过程里,图像和音频的原始特征根本没有和文本特征在同一个语义空间里打通。
真正的跨模态对齐,是让模型在语义层面把“猫的照片”“猫的叫声”“‘猫’这个字的文本描述”映射到同一个向量坐标上。不管你给它看猫、学猫叫、写猫字,它都能反应过来这说的是同一个东西,甚至能根据一段猫叫的音频,在脑子里生成对应的猫的影像。
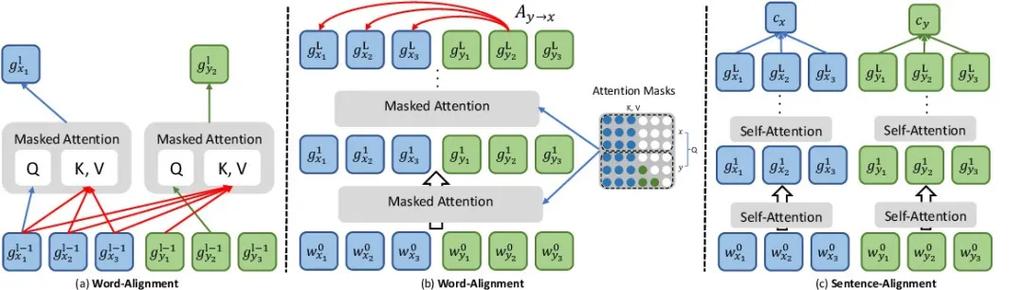 多模态大模型跨模态向量空间对齐示意图
听起来很美对吧?
实际跑起来的瓶颈,比所有人想象的都大。不同模态的信息密度差得离谱——一段100字的日常对话,有效语义点也就30个左右;一张4K分辨率的照片,像素点是800万;一段10秒的音频,时序采样点是44.1万。要把这些信息密度天差地别的数据,拉到同一个向量空间里对齐,训练算力是同参数纯文本大模型的3-5倍,还特别容易出现“模态偏科”。
我上次测某头部厂商的开源多模态模型,给它看我家猫踩在键盘上拍的乱码照片,它认认真真分析了三分钟,说这是某互联网公司的内部加密文档,承载了30%的核心技术信息。
离谱吧?
你说它傻吧,它能准确读出照片上的每一个乱码字符。你说它聪明吧,它根本意识不到这是猫踩出来的无意义内容。这就是典型的偏科——文字识别模块练得太好,图像的整体语义理解根本没跟上。
现在吹得最凶的落地场景,其实一半都在“装演示”
过去一年我跑了快20个多模态相关的项目,见过最多的套路,就是“演示即巅峰”。
很多厂商的demo都是提前精心调试的:测试样本要在固定光照、固定角度下拍好,提前喂到模型里做定向微调,现场演示的时候,摄像头对着提前准备好的样本,识别准确率能达到99%以上。你要是现场换个角度,或者拿个和训练集里特征稍微差一点的样本,它立刻就露馅。
别信。
真的。
就拿现在宣传最多的三个场景说:
第一个是工业质检。演示的时候,模型能1秒找出金属零件表面的0.1毫米裂缝,真拉到车间跑,车间里的灰尘、设备震动带来的图像模糊、不同批次原材料的自然色差,全是模型没见过的分布外数据,错漏率直接从1%飙到20%。
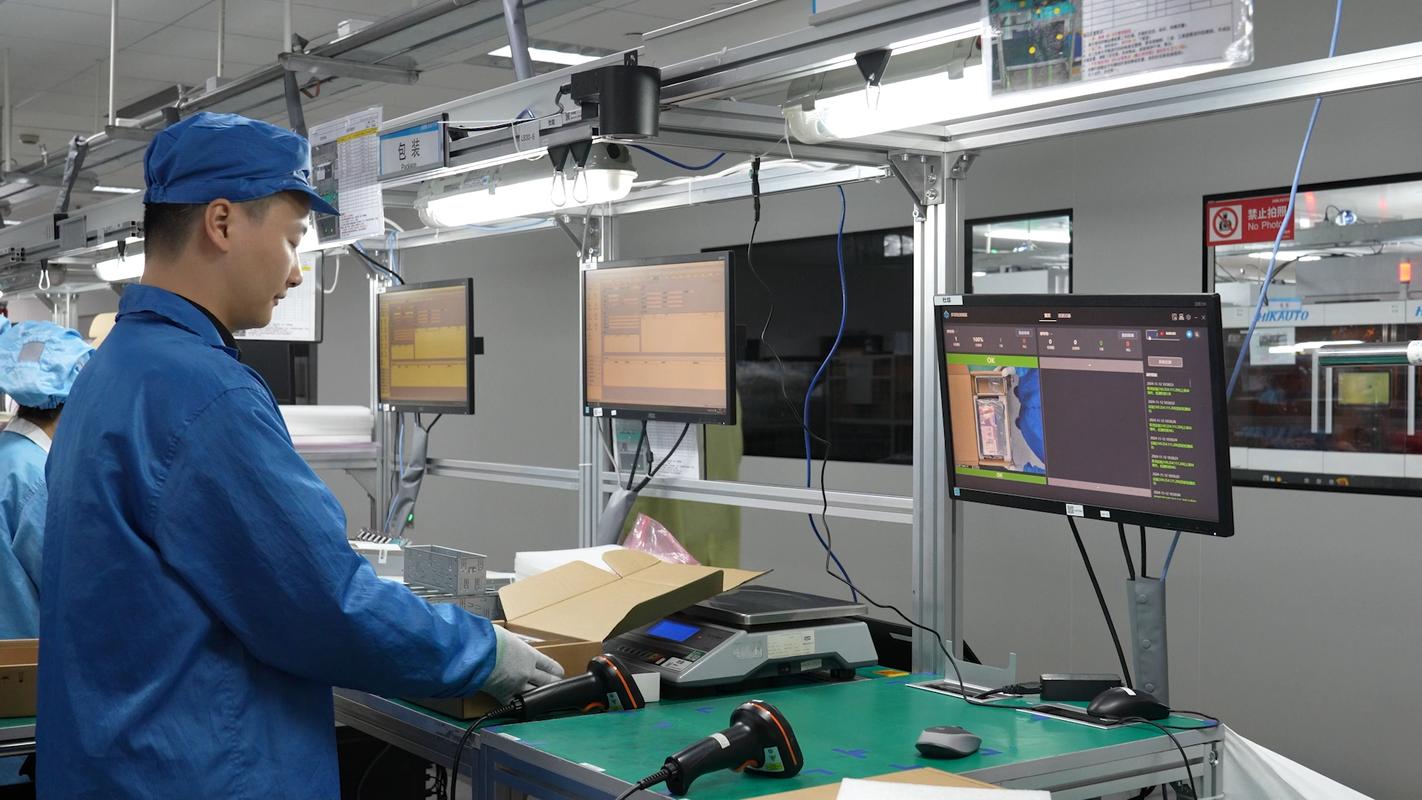 工业车间多模态质检摄像头部署实景
第二个是医疗辅助诊断。很多方案说多模态能同时读CT片、检验报告、电子病历,给医生出诊断建议。实际上现在的模型对影像的识别精度,还不如从业5年的影像科医生,遇到罕见病的影像特征,给出的结论全是模棱两可的正确废话,根本不敢给临床用。
第三个是电商内容生成。说多模态能“看商品图自动写详情页、自动生成直播脚本”,实际上写出来的东西全是套话——给个露营帐篷的图,它能写“这款帐篷具有良好的户外使用属性,能够满足您的出行需求”,根本抓不住用户真正关心的“防暴雨等级、自重多少、能不能同时容纳4个成年人”的核心卖点。
现在整个产业链的生态特别有意思:做基础模型的厂商关起门来练参数,说自己的模型效果世界第一;做应用集成的公司拿开源模型套个壳,就敢出去谈百万级的订单;最后交付的时候达不到效果,客户转头就骂整个行业都是骗子。
不过话说回来,也不是所有场景都在装。比如那种边界被锁得特别死的场景——比如固定通道里的人脸识别门禁,比如固定位置拍的金属零件缺陷检测,这种场景下所有变量都被提前控制住了,多模态模型的效果确实比传统的机器视觉方案好很多,现在已经在批量落地了。
被所有人忽略的治理隐形成本,才是真正的拦路虎
 被所有人忽略的治理隐形成本,才是真正的拦路虎
聊技术聊落地的人很多,聊治理的人很少。
多模态大模型和之前的纯文本大模型,从根上就不是一个物种。纯文本大模型是你问一句,它答一句,交互是有边界的。多模态大模型是能看、能听的,它的感知是全天候、无边界的。
这就带来了一堆之前根本没遇到过的问题。
首先是训练数据的版权问题。现在主流多模态模型的训练集里,爬了几十亿张网络图片、几百万小时的网络音频、几十万段公开视频。这里面有多少内容是有明确版权的?有多少是普通人随手发在社交平台的私人照片?之前看到过一个插画师的吐槽,说自己画了3年的原创插画,被多模态模型学走了风格,现在只要输入提示词,10秒就能生成和她风格几乎一模一样的作品,她连找谁维权都不知道。
然后是隐私问题。现在的多模态模型,能从一段10秒的普通人说话的音频里,提取出对方的情绪状态、有没有哮喘这类基础疾病,甚至能通过背景的杂音,判断对方当时是在办公室还是在超市。要是这个模型被装到智能音箱、车载摄像头、办公会议系统里,你在设备旁边的所有对话、动作、表情,都被模型采集分析了,这根本不是之前那种“你主动问才会被记录”的场景,是被动的、全天候的感知。
还有偏见的问题。我上次看到某公司的多模态门禁系统,识别外国员工的时候开门速度是1秒,识别中国员工的时候要3秒,还经常识别错,把人锁在门外。原因特别简单——训练集里的人脸图片,70%都是欧美白人,东亚面孔的特征样本占比不到10%,模型根本没学全。这种问题根本不是靠多喂点数据就能一劳永逸解决的,是整个训练流程里对小众群体的特征覆盖不够,本质是偷懒。
我上次看到某公司的多模态客服系统,对着一个说话带西南口音的用户,连续三次把对方的“我要退货”识别成“我要投诉你们的食品有异物”,最后把人惹得火冒三丈。你说模型故意的?根本不是,是训练集里的西南口音样本太少,模型分不清“退货”和“异物”的发音差别。
很多人问我,多模态大模型到底什么时候能真的起来?
我的判断很简单:未来3年,通用端到端多模态大模型根本不会达到能替代人类感知能力的水平,现在大家吹的“能看、能听、能说、能摸”的通用AGI,至少还要再磨5年。
真正能跑通的落地场景,从来都不是那些吹得震天响的通用场景,而是边界清晰、变量可控的垂直场景——比如固定光照下的工业质检、设计行业的素材辅助生成、教育场景的口语发音纠正。这些场景里,多模态模型不需要什么“通用智能”,只要把某一个细分任务的准确率做到比传统方案高10%,成本低30%,就有商业价值。
未来的行业洗牌也会很快。现在那些靠套壳开源模型、靠PPT拿融资的公司,最多撑18个月。等基础模型厂商把推理成本打下来,把开源模型的效果提上去,这些没有核心技术的集成商根本没有生存空间。最后活下来的,都是能沉下心来,把模型效果和真实场景的误差控制在可接受范围里的玩家——不是靠演示拿订单,是靠真实的交付效果留客户。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:多模态大模型:吹了三年的技术,还没跨过落地的第一道坎
文章链接:https://m.lfdjt.com/info_23_25737.html
 大讲堂
