2026-10-14 05:52:06 作者:大讲堂
凌晨两点的杭州未来科技城,机房的冷风吹得我后颈发僵。张工把手里的冰美式往防静电地板上一墩,罐身砸出闷响。
“又崩了。”
跑了1200亿参数的模型,认不出我奶奶的手写借条
我们当时接了省档案馆的项目,要把建国以来的几十万份手写档案扫描成可检索的电子档。前期路演的时候,我们把PPT做得天花乱坠,说靠深度学习的OCR能力,能把档案识别准确率拉到98%,三个月就能干完原来三年的活。
结果上线第一周,我随手掏出口袋里揣的、我奶奶塞给我的老借条——1998年写的,纸是从作业本上撕下来的,边角沾了点当年的酱油印,字歪歪扭扭的,“今借到伍佰元整”几个字,那个“伍”写得连笔快成“五”了。我把扫描件喂给模型,等了三秒,结果跳出来:“今借到五百无整。”
我当时笑到直拍桌子。张工凑过来看,脸瞬间绿了!
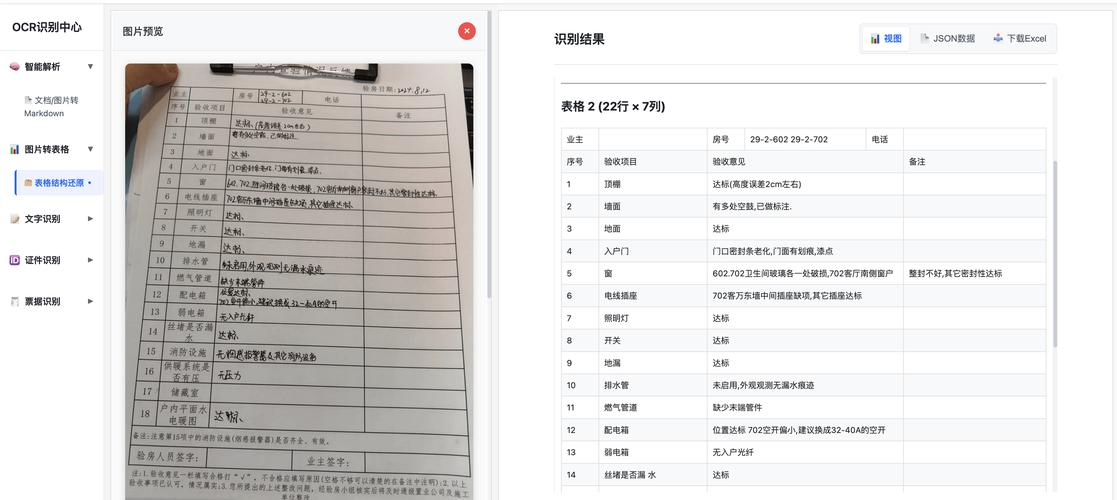 老旧手写档案OCR识别错误案例截图
我们当时微调的是训练了3000万张正规印刷票据的大模型,按理说日常票据识别的准确率高到离谱,为什么栽在这张破纸上?答案说出来有点可笑——训练集里的所有“伍佰元”,要么是银行印在正式单据上的宋体字,要么是储户在印刷规整的存款单上写的楷书,从来没有沾了酱油印、写在作业本纸上、连笔快认不出来的字。
它根本不是会“学习”,它只是把见过的东西,拼得像那么回事而已。那天我盯着屏幕上那个错得离谱的识别结果,突然反应过来,之前被各路科普吹得神乎其神的深度学习,原来本质上是个“模仿高手”。它从来不会真的理解“伍佰元”是什么意思,它只是在见过的几千万个“伍佰元”的字形里,找个最像的匹配给你。一旦遇到训练集里没见过的场景,它就露馅。说实话,我当时第一反应不是技术不行,是突然觉得这东西跟我家刚上小学的侄子没差——背了一整本生字表,遇到没见过的字就瞎蒙。
机房里没人说的秘密:它的“聪明”,全靠人在后面擦屁股
很多外人觉得,深度学习的模型一旦训练完,就能自己跑,自己进化,人等着收结果就行。根本不是。我们当时每周要处理的识别错误样本,能攒满满两个硬盘。这些错漏的样本,全靠人一个个标出来,告诉模型“你刚才认错了,正确的字是这个”,再喂回去重新训练。
我们组里的小周,去年刚毕业的小姑娘,每天的工作就是对着屏幕标这些错漏。有次我路过她工位,看见她盯着屏幕掉眼泪。屏幕上是连续第三十个被模型认错的“陈”字——用户手写的“陈”,左耳旁写得太开,模型直接识别成了“阵”。她上周刚熬了三个通宵,标完1200份来自全国不同地区的手写快递单,就为了让模型把这个姓认对,结果上线第一天,还是错。
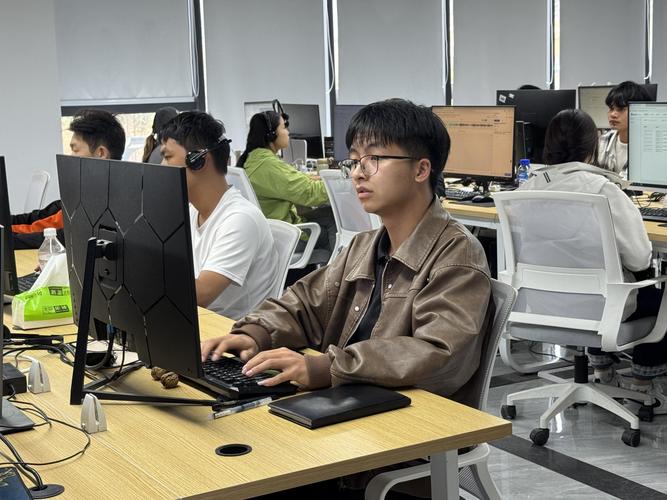 深度学习badcase人工标注工位实拍
她工位的隔板上贴了张便签,字歪歪扭扭的:“我在给人工智能当妈。”
我当时站在旁边,半天没说出话。
大家总说深度学习的算力贵,模型大,烧钱如流水。很少有人提,那些藏在屏幕后面,日复一日给模型擦屁股的人,才是这个系统里最沉默的部分。我们算过一笔账:跑一次全量模型推理的电费,够整个组吃三顿重庆火锅;要把手写档案的识别准确率从92%拉到99%,得再标至少500万份不同场景的样本,算下来的人力成本,比请两个退休的老会计坐在档案室里逐份翻档案,贵了快四倍。你说扯不扯?我们砸了几百万搞的技术,最后算下来,性价比还不如两个戴老花镜的退休阿姨。
它就是个胃口极大的吞金兽。你喂给它什么,它就长成什么样。你喂的东西全是正规场景的印刷字,它遇到沾了酱油的借条就直接瞎。你喂的样本里手写“陈”字全是规规矩矩的楷书,它遇到写得开的左耳旁就认成阵。哪有什么无师自通的聪明啊,全是人在后面一点点把它教出来的。
它最厉害的地方,从来不是代替人
 它最厉害的地方,从来不是代替人
后来我们那个项目没死磕“100%识别准确率”的目标。改了方案。
我们把模型的功能拆了:它只负责干两件事——第一,把字迹清晰、没有污渍、印刷规整的档案,自动识别成电子文本,不用人管;第二,把那些皱巴巴、沾了水、字歪歪扭扭、识别置信度低于阈值的档案,单独挑出来,推到档案管理员的工作界面上。
就这么个简单的调整,原来档案馆的李阿姨她们,要花整整三个月才能干完的活,两周就弄完了。我记得李阿姨快60了,之前每天对着堆到天花板的档案翻,腰间盘突出的老毛病犯了,得扶着桌子站半天才能缓过来。现在每天下午三点,她就能准时下班去小学门口接孙子。有次她在走廊碰到我,塞给我一把自己家烤的核桃,壳薄得一捏就碎。“这机器比我家那小子靠谱,至少不跟我顶嘴,让它干啥就干啥。”
有天我留在机房改参数,凌晨一点多,屏幕上的模型跳出来一条识别结果:一张1976年的入伍登记表,边角被虫蛀了个洞,边缘的字全模糊了,模型精准抓出了中间的核心信息:“张三,1976年3月入伍,籍贯浙江余姚”。剩下那些模糊的、被虫蛀的字,它老老实实标了“待人工确认”。
我当时突然就想通了。之前大家对深度学习的误解,真的太深了。总有人说它要取代所有岗位,要变成无所不能的神,要把人类的工作全抢光。但实际上,它就是个力气很大、眼神不太好、记性特别好的实习生。
你让它独立扛所有事,它肯定给你捅娄子,把“伍佰元”认成“五百无”,把“陈”姓认成“阵”姓,遇到没见过的场景就直接卡壳。但你给它搭好边界,告诉它什么事适合它干,什么事必须交给人来兜底,它能把最磨人的、重复的、耗精力的活,全给你扛了。它不会嫌档案堆得高,不会因为翻了一天的文件腰杆疼,不会因为标了一千个样本觉得累——当然,累的是后面给它擦屁股的人,但至少这些累,最后换成了李阿姨能准时接孙子的下午,换成了我们不用再对着几十万份档案熬大夜。
上周我奶奶给我打电话,说她翻旧箱子的时候又看到了那张1998年的借条。我掏手机用自带的识别功能拍了一下,这次屏幕上跳出来的结果分毫不差:“今借到伍佰元整,1998年6月”。
我盯着屏幕看了半天。
现在全网都在聊大模型,聊AGI,聊深度学习要怎么颠覆世界。各种发布会开得热热闹闹,好像再过半年,我们就能被人工智能伺候得衣来伸手饭来张口。但我总想起杭州那个冷得像冰窖的机房,想起墩冰美式的张工,想起掉眼泪的小周,想起李阿姨塞给我的薄皮核桃。
哪有什么从天而降的神啊。
不过是一群普通人,对着一堆代码,一点点给那个没见过世面的模型,教它认字,帮它找对位置,看着它慢慢长出能帮人搭把手的力气而已。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:深度学习不是神:我在杭州机房蹲了3个月,看见它最狼狈的样子
文章链接:https://m.lfdjt.com/info_23_25732.html
 大讲堂
