 大讲堂

2026年春天的智能座舱圈,藏着个没人愿意公开聊的秘密。
某头部新势力的OTA更新,偷偷把端侧语音控制模块从之前吹了半年的7B量化大模型,换回了2014年就成熟的GRU模型——也就是RNN的一个常见变体。
没人敢发通稿说这个事。
毕竟2024年的发布会上,老板还拍着胸脯说,自己家的智能座舱是全行业第一个实现端侧7B大模型落地的,是面向未来3年的技术方向。
换回去的原因说出来都丢人:之前的大模型方案,单次语音唤醒的功耗是12mW,换回GRU之后直接降到1.1mW。这是什么概念?同一块500mAh的车钥匙电池,大模型方案3个月就得拆下来换,RNN方案能撑4年。更别说之前大模型方案因为功耗太高,车停一周就亏电打不着火的投诉,占了整个客服投诉量的21%,换回RNN之后,这个投诉率直接降到了0.3%。
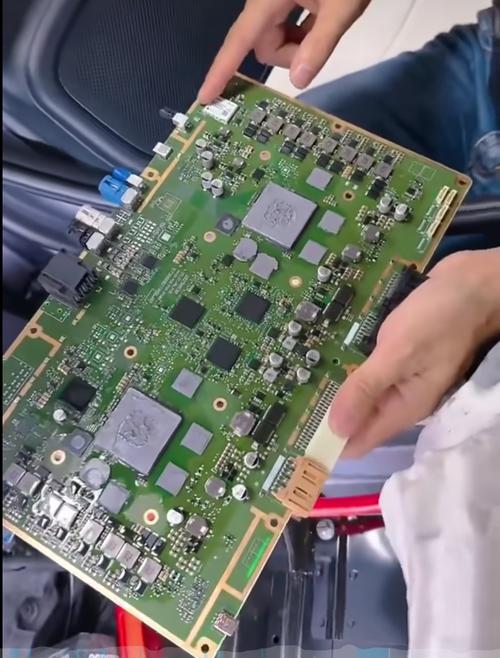
我当时跟深圳某供应链的总工吃饭,他喝了半斤白酒才敢说,2024年为了赶大模型的风口,他把团队里三个做了10年RNN的老算法工程师全优化了。现在要重新招人,开的工资是之前的3倍,还招不到合适的。
“真的,之前谁提RNN,谁就像没上过大学一样,现在倒好,整个行业都在偷偷找会写GRU的人,连面试题都是2018年的原题。”
这话我信。2024年我去参加深圳的电子展,但凡展台上的方案提一句RNN,路过的采购都要绕着走,觉得这是上世纪的老古董,拿不出手。结果才过了一年,大家又开始抢着跟做RNN方案的供应商合作。
被绑架的技术路线,从来不是用户选的
很多人说RNN不行,是因为梯度消失,长序列记忆差,跑长文本的时候根本比不过Transformer。
这话没错。
但没人算过一笔最基础的账:端侧场景下,90%的语音交互,序列长度根本不超过200个token——也就是你说一句“打开空调,调到24度”这么长的话,RNN的记忆能力完全够用,根本不需要什么跨1000个token的长序列注意力。
恒玄科技2025年推出的那款给TWS耳机用的低功耗芯片,最初的参考设计里,给客户提供的语音唤醒方案是基于Transformer的,需要芯片的NPU跑到1TOPS的算力才能流畅运行。结果OPPO的TWS团队拿到样片之后,自己把方案换成了GRU,测下来发现,只需要10GOPS的算力,就能达到跟Transformer方案一样的唤醒准确率,算力差了整整100倍。
100倍的算力差是什么概念?就相当于你本来需要一张RTX4090显卡才能跑的3A游戏,现在用树莓派的算力就能流畅满帧跑。
为什么整个行业之前都不愿意提这个事?
因为算力厂商的利润,是跟算力规模绑定的。你用RNN,10GOPS就够,人家卖什么1TOPS、10TOPS的高算力芯片?所以过去三年,所有的行业峰会、所有的技术白皮书、所有的媒体报道,都在说RNN是上世纪的过时技术,未来是Transformer的天下。
这就像二战时候的装甲战术,所有国家的军工企业都铆着劲造虎式坦克——装甲厚,主炮射程远,看起来威风凛凛,是未来的装甲发展方向。结果真打起来才发现,绝大多数前线的交火距离根本不超过500米,虎式那门能打2公里的长管炮根本派不上用场,反而因为油耗太高,一半的坦克没开到战场就因为没油抛锚,成了盟军的活靶子。而RNN就像当年的T-34,结构简单,皮实,油耗低,虽然没有虎式那么猛的火力,但是在绝大多数日常交火场景下,完全够用,甚至因为能大批量生产,能打赢那些造价高昂的虎式。
我一直觉得,过去三年整个端侧AI的技术路线,根本不是用户用脚投票选出来的,是被上游芯片厂商的利润需求给绑架了。用户根本不需要在耳机里跑什么长文本理解,不需要让手表帮你写周报,他们只需要唤醒的时候快一点,续航久一点,别一天三充就行。
被风口晃晕的人,迟早要还的
这波RNN回滚的浪潮里,最尴尬的就是那些被风口晃晕的从业者。
某招聘平台2026年Q1的内部数据显示,端侧算法岗位里,要求掌握RNN、GRU、LSTM等传统序列模型的岗位占比,从2024年的3%,直接涨到了47%。但对应的人才储备呢?2024年一年,整个行业把80%的算法培训预算都砸在了大模型微调、Transformer架构优化上,会写RNN的人,只有2022年巅峰时期的15%。所以现在这些能把RNN模型压到KB级大小的工程师,薪资比那些做云端大模型微调的人还要高30%——这就是3倍成本挖人背后的真实人才缺口。
说实话,2024年我去参加上海的AI峰会,但凡有人在PPT里提一句LSTM,台下的人都要低头刷手机,觉得这人是从2018年穿越来的,不懂行业趋势。结果才过了一年,大家又开始抢着要这些“过时”的工程师。
我认识好几个2023年从端侧团队跳槽去大模型团队的算法工程师,现在天天在朋友圈吐槽,说当年为了面试,把简历上所有跟RNN相关的项目经历全删了,现在要重新把这些经历写回去,连面试的时候都不好意思说自己当年觉得RNN是垃圾。
还有那些靠“端侧大模型”概念拿了融资的创业公司,之前的核心业务就是把7B的大模型压到能在手机、耳机上跑,估值炒到了十几亿。结果2026年开年,客户反馈说,你压的这个大模型,续航还是不行,人家用RNN的方案,续航是你的10倍,准确率跟你差不多,谁还买你的方案?所以这批公司开年就裁了一半的研发人员,估值直接砍到脚踝。
上周在咖啡馆碰到个刚从某头部大模型公司离职的算法工程师,他说现在正在翻2018年的旧代码,捡当年删掉的LSTM实现,准备去端侧团队找工作。
那你呢?你硬盘里藏着的那些被你当成过时垃圾的老技术,现在还敢拿出来用吗?
作者|大讲堂
排版|大讲堂
审核|阿辰