 大讲堂

2026年开年的那堆“烫手”的服务器
说实话,我3月份去杭州未来科技城跑行业交流,顺道拐去了旁边的二手服务器交易市场。 那场面我到现在都记得。 货架上堆着一整排贴了某互联网大厂标签的H100节点,外壳上的封条还没撕干净,老板开价是采购价的3折。问了下才知道,这堆机器全是之前给向量数据库集群配的,因为团队调整方向,整套集群直接打包甩卖。 这事太扯了。 之前2023到2025年那波大模型创业潮里,几乎所有做端到端大模型应用的团队,都把“自建向量数据库”当成了写BP的时候必吹的核心壁垒,好像没个自己的向量库,都不好意思跟VC说自己是做AGI的。结果刚过了两年,这些花大价钱搭起来的集群,就成了二手市场上没人接盘的烫手山芋。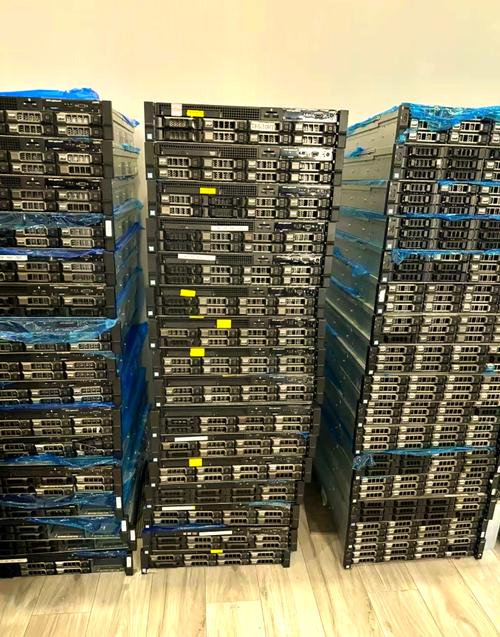
卷到最后,拼的根本不是检索算法
很多人对向量数据库的认知还停留在“大模型的配套技术”层面,觉得谁的检索算法更先进、支持的向量维度更多,谁就能赢。 错了。 本质上这轮国内向量数据库厂商的竞争,和2018年那波快递行业的末端网点扩张战没什么区别——你以为大家拼的是快递员的送件速度、服务态度,其实拼的是谁能在社区旁边拿到最便宜的仓储用地,谁的单件履约成本能压到5毛以下,谁就能把对手挤出去活下来。 就拿深圳的Zilliz来说,他们做的开源向量数据库Milvus,2024年之前在国内的市场份额还不到15%,被海外的Weaviate、PineCore压着打。结果2025年他们直接把整套系统的存储冗余砍了30%,把1TB向量的年存储成本压到了海外同类产品的1/3,半年时间就抢了国内60%的政企大模型项目的向量库订单。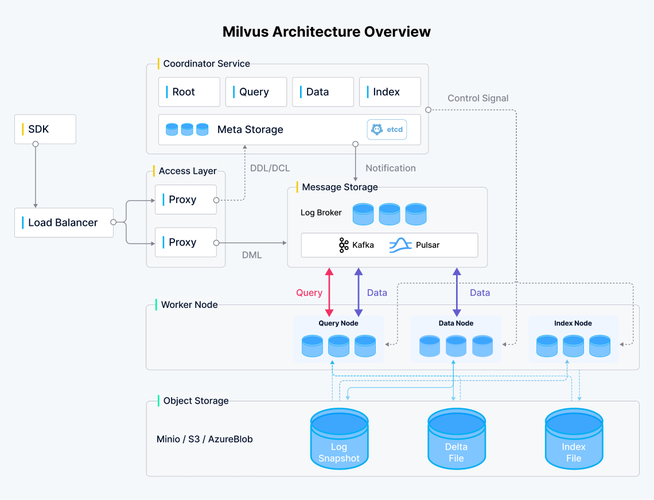
普通人别被风口的幌子骗了
我最近接了好几个做开发的朋友的咨询,说看到向量数据库是新风口,花了大几千报了培训班,学什么HNSW算法、IVF索引,学完投简历才发现,企业招人的时候根本不要求你会写底层的检索算法,就要求你会调开源Milvus的接口,会算清楚不同方案的成本账。 说穿了,现在企业的IT负责人早就不被技术概念忽悠了。你跟他说你的向量库支持多少种距离计算方法、检索延迟能做到多少毫秒,他根本不关心,他第一句话永远是问:“你这1TB的存储一年收我多少钱,比隔壁家便宜不?” 就拿大家最常用的RAG知识库场景来说,一个10万条文档的内部知识库,用PostgreSQL自带的向量扩展模块,一年的成本也就大几千块,效果和专门的独立向量库差不了5%。之前大家都觉得技术越新越好,现在算完账才发现,很多场景根本不需要花大价钱上专门的向量数据库。 对吧?你花20万买的专业咖啡机,冲出来的咖啡和公司茶水间300块的胶囊机,喝起来根本没区别,那你这20万不就是纯纯交智商税? 现在整个产业链的流向已经很明显了:之前那些追着风口学底层算法的工程师,很多都转去做成本优化的方向了——不是去搞更复杂的检索模型,而是去算怎么把每TB的向量存储成本再压个20%,怎么把检索的冷启动时间再降个100ms。毕竟客户现在用脚投票,谁的成本低就选谁,那些花里胡哨的功能,根本换不来真金白银的订单。 我上个月跟一个做云服务的朋友聊天,他说现在他们团队接到的向量库相关需求,70%都是原来用普通数据库的客户,被销售忽悠了半天才愿意试试,真正从一开始就需要高并发、高维度向量检索的场景,占比还不到10%。 等明年大家都发现,把向量检索直接嵌到通用关系数据库里就能搞定90%的中小场景,现在砸了几十亿建的独立向量数据库集群,最后会不会都变成二手市场上3折甩卖的废铁?作者|大讲堂
排版|大讲堂
审核|满满