 大讲堂

上周跟一个做金融科技的朋友吃饭,他吐槽说自家花了几十万微调的行业大模型,给客户出的研报里居然把某上市公司去年的营收数字写错了——错得还挺像那么回事。
这不是个例。
从ChatGPT爆火到现在快两年,大模型幻觉一直是绕不开的坎:你问它一个行业的细分数据,它能给你编得有鼻子有眼,连出处都像模像样,仔细一查全是错的。之前还有人吹,只要模型参数够大,训练数据够多,幻觉自然就消失了。结果到现在,千亿参数的模型照样一本正经胡说八道,训练数据的成本更是高到普通企业根本承担不起。
检索增强生成(也就是大家常说的RAG),就是在这种背景下被推到台前的。
先厘清边界:检索增强生成不是“给大模型开个网”
很多人对RAG的误解,从名字就开始了。有人觉得这就是给大模型加个联网搜索功能,用户提问的时候先搜一下互联网,再把结果塞给大模型回答。错得离谱。
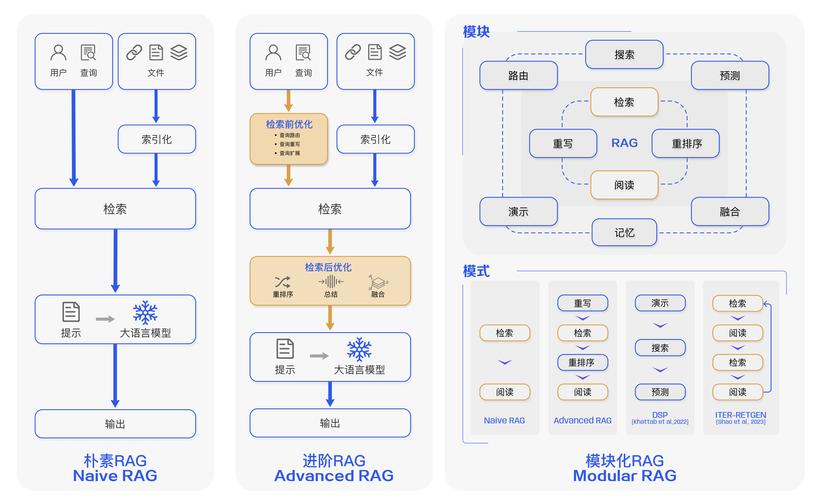
本质上,RAG是给大模型做了一套“开卷考试”的机制。大模型本身的静态参数记忆是封闭的,训练完成之后,它脑子里的知识就固定了,既没法实时更新,也没法调用企业自己的私有数据。RAG的流程是:先把企业自己的所有文档(制度、研报、合同、产品手册)按照语义切分成小的片段,把这些片段转成向量存在专门的向量数据库里;用户提问的时候,先把问题转成向量,去数据库里召回最相关的几个片段,再把这些片段和问题一起塞给大模型,让它严格基于给定的片段回答,而不是靠自己的记忆瞎编。
说实话,第一次搞懂这个逻辑的时候我还挺惊讶——这么简单的思路,居然直到2023年才成了产业界的香饽饽?其实早在上世纪90年代,就有学者提出过检索增强生成的雏形,只是那时候的大模型没有这么强的自然语言理解能力,检索回来的内容和问题匹配度极低,塞给模型也生成不了靠谱的回答。直到近两年通用大模型的语义理解能力上来了,这套机制才终于跑通了。
这里还要划个重点:RAG不是万能的。它解决的是“事实性错误”的问题,也就是大模型因为记忆偏差、知识过时导致的错误,但是解决不了大模型本身的逻辑推理能力差的问题。比如你让它做一道复杂的数学题,就算给它递上了公式手册,它该算错还是算错。
产业落地的现状:RAG已经进化到第二代了
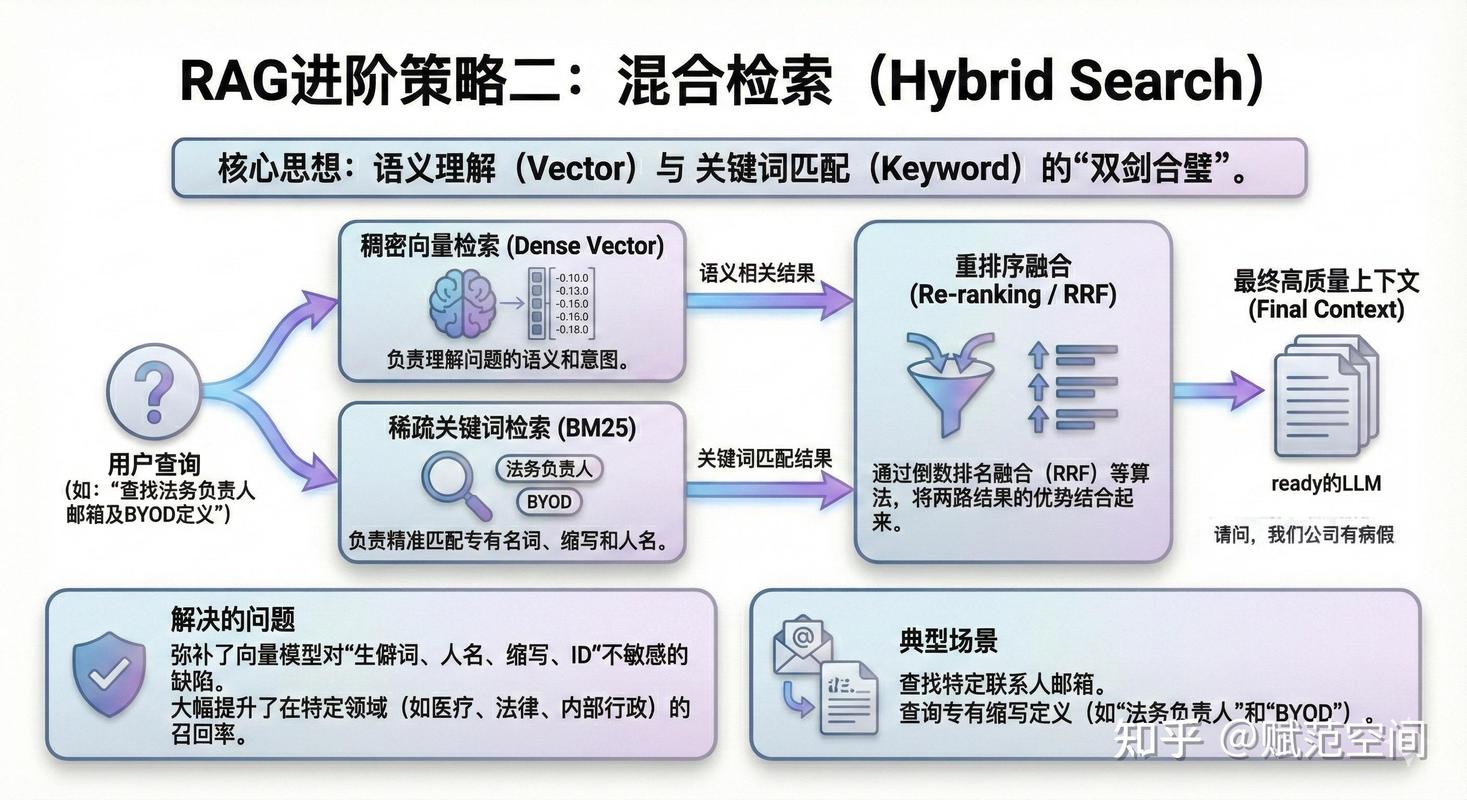
最早一批落地的RAG,基本都是“初代版本”:文档硬切,比如按512个token一刀切,经常把一份合同里的核心条款切成两半,要么上半部分在一个片段里,下半部分在另一个片段里,召回回来的内容断章取义,反而让大模型错得更离谱。检索也是纯靠向量语义匹配,有时候用户问的是带精确数字的问题,比如“2024年公司的差旅报销额度是多少”,向量匹配可能召回一堆讲差旅制度的通用内容,反而找不到带具体数字的那一条。
现在产业界用的RAG,已经进化到第二代了。首先是语义切片,不再是硬按长度切,而是按照文档的自然结构切,比如合同里的每一个条款、研报里的每一个论点、产品手册里的每一个功能说明,单独作为一个切片,保证每个片段都是完整的语义单元。然后是混合检索,不再只靠向量语义匹配,同时加上传统的关键词检索(BM25算法),比如用户搜“宁德时代2023年储能营收”,关键词检索能直接定位到带这几个关键词的文档片段,和向量检索的结果合并之后,匹配度比纯向量检索高一大截。最后还要加一层重排序,就是召回回来的前20个片段,再用一个小的专用模型给每个片段和问题的相关度打分,取最相关的前3-5个塞给大模型,减少噪声干扰。
现在已经有不少落地的案例了。比如头部的协同办公软件厂商,内置的大模型助手就是用的第二代RAG架构,员工问“今年的年假天数是多少”,系统直接从公司最新的人事制度文档里召回对应的条款,不会给你通用的劳动法规定的年假标准。还有不少券商的投研助手,RAG会实时对接最新的上市公司公告、行业研报、宏观经济数据,给分析师的每一条回答都标注对应的来源链接,错了可以直接溯源。
不过话说回来,这两年产业风向变得也真快。去年还有不少厂商吹自己微调的行业大模型有多牛,动辄报价几百万一套,今年全转去讲RAG了。谁的钱也不是大风刮来的,原来微调一套行业大模型要养几十人的算法团队,还要花几百万买算力喂数据,现在只要把自己的知识库整理好,接一个开源的通用大模型,搭一套RAG流程,成本可能只有原来的十分之一,效果还更好。换你是企业老板,你选哪个?
没人明说的坑:RAG的天花板远没到吹的那么高
厂商的宣传里,RAG是解决所有大模型问题的万能药,实际上真用起来,坑一点都不少。
第一个最常见的坑,就是知识库的治理成本。很多企业的文档库本身就是一团乱麻:同一个制度有好几个版本,2019年的旧制度和2024年的新制度存在同一个文件夹里,文档命名全是“最终版”“绝对最终版”“打死不改版”,RAG根本分不清哪个是最新的,很容易召回旧的内容,给的回答全是错的。我之前接触过一个做制造业的客户,他们的产品手册有十几个版本,RAG经常召回已经淘汰的旧型号的参数,给客户的回答错漏百出,最后花了整整三个月整理知识库,才把问题解决。
第二个坑,是权限和数据安全的问题。现在大部分企业的文档都是分权限的,比如普通员工看不到核心部门的机密文档,但是RAG的向量数据库如果没有做权限过滤,用户提问的时候,系统可能直接把其他部门的机密内容召回回来,相当于给所有用户开了全量数据的权限,很容易造成数据泄露。之前就有过案例,某企业的RAG助手,普通员工提问的时候,居然召回了高管的薪酬文档,闹得沸沸扬扬。
还有更隐蔽的问题,就是内容偏见和溯源造假。如果知识库本身的内容就有偏见,比如招聘文档里写了“不招35岁以上的候选人”,RAG就会把这个内容当成正确的依据,给的回答自然就带着歧视性。更有意思的是,很多厂商宣传RAG的回答带溯源链接,实际上现在不少RAG系统的溯源是乱标的——明明召回的是A文档的内容,结果标注成B文档的链接,用户点进去根本找不到对应的内容,反而更误导人。
到现在为止,整个RAG行业还没有统一的标准,从文档切片、检索、重排序到最终生成的全流程,每个厂商的实现方式都不一样,出了问题根本扯不清责任。比如之前有个医疗领域的RAG助手,给病人的用药建议错了,溯源发现是召回了一个过期的医学指南里的内容,但是到底是知识库的问题,还是检索的问题,还是大模型生成的问题,各方扯了半年都没扯清楚。
未来3-5年的判断:RAG不会是终局,但会是标配
现在行业里很多人在吵,到底是RAG好还是微调好,会不会RAG出来之后,微调就没用了。其实根本不是二选一的问题。
首先可以肯定的是,未来3年,RAG会从现在的“单轮检索”进化到“多轮推理检索”。现在的RAG都是用户提一个问题,直接召回相关的内容塞给大模型,但是如果用户的问题很复杂,比如“对比宁德时代和比亚迪2023年储能业务的营收、毛利率和海外市场占比”,一次召回根本没法覆盖所有需要的信息。未来的RAG会让大模型先拆解问题,分步骤去检索需要的信息,先召回宁德时代的储能相关数据,再召回比亚迪的,最后再整合起来回答,准确度会比现在高很多。
其次,RAG一定会和微调结合起来,而不是互相替代。微调解决的是大模型的“风格”和“通用能力”的问题,比如企业可以用微调把大模型的回答语气改成符合自己公司的要求,比如客服的语气要温和,投研的语气要严谨;而RAG解决的是“事实”的问题,给大模型提供实时的、私有的数据。两者结合才是最优解,根本不存在谁取代谁的问题。
最后,未来会出现专门的RAG基础设施厂商。现在大部分企业搭RAG,都是自己从切片、向量库、检索到重排序一步步搭,相当于每个企业都在重复造轮子。未来会有专门的厂商把这些流程做成标准化的服务,企业只要把自己的文档传上去,就能自动完成语义切片、权限配置、检索调优,直接生成符合自己需求的RAG助手,不用自己写一行代码。
上周那个做金融科技的朋友给我发消息,说他们已经把原来微调的大模型丢到一边,换成了RAG架构的系统,现在研报里的数字再也没错过,整体成本还降了七成。
挺有意思的。
原来解决大模型落地的问题,不一定非要靠更大的模型,更贵的算力。
有时候,给它指个正确的参考书,就够了。
作者|大讲堂
排版|大讲堂
审核|白杨