 大讲堂

这话听着刺耳,但太真实了。
过去十年大家对DL的印象,要么是实验室里能下赢围棋的超级AI,要么是融资发布会上吹上天的通用人工智能,很少有人真的沉下来算一笔账:这东西落地到真实产业里,到底值多少钱?
别再把DL当万能魔法:技术边界其实早就画好了
很多人对DL的认知还停留在2016年AlphaGo赢李世石的阶段,觉得这东西无所不能。错得离谱。
DL的本质说穿了根本不是什么”智能”,就是基于海量标注数据的统计拟合——你给它看一百万张猫的照片,它就能总结出猫的像素分布规律,下次碰到新的照片,能大概率认出是猫。它没有真的”理解”什么是猫,只是摸透了数据里的统计关联。
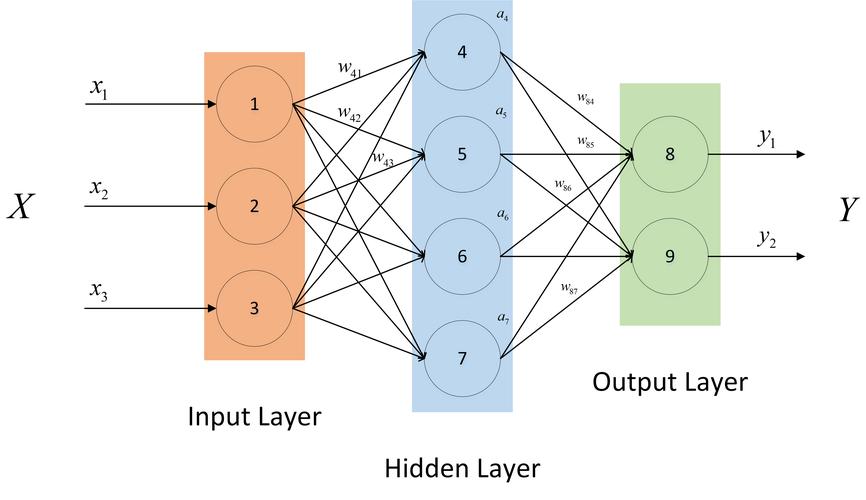
这个本质直接把DL的技术边界划得明明白白:只要是数据分布稳定、有足够多的标注样本、就算偶尔判错也不会出大问题的场景,DL就能跑的很顺,比如刷脸解锁、短视频推荐、商品图生成。反过来,如果是小样本场景、数据分布经常变、要求绝对不能出错的场景,DL现在还是抓瞎。
说个扎心的事实:现在很多工厂里用的所谓”DL智能质检”,碰到非标件、碰到客户改了产品外观,模型准确率直接从99%掉到60%,还不如用了十年的老规则引擎稳。很多做项目的公司没办法,只能偷偷在模型外面套一层规则兜底,最后对外宣传还是”全DL驱动”。
对吧?哪有什么万能魔法。
当下DL的产业现状:算力账算不过来的尴尬
2023年之前的DL产业,说白了就是一场算力狂欢。大家拼了命的堆参数,从最早的几千万参数,到后来的几十亿、上百亿,现在动辄就喊”万亿参数通用大模型”。没人真的算过账:训这么大的模型,要烧多少张A100,要交多少电费,最后产生的商业价值能不能覆盖成本?
账现在算不过来了。
去年某头部云厂商的内部测算,训练一个千亿参数的通用大模型,光是硬件和电力成本就超过3亿,每年的运维成本还要再加1个亿。但现在这些通用模型的付费转化率,连1%都不到。
于是大家转头开始卷小模型的优化。
说白了就是把原来需要一堆服务器才能跑的大模型,通过蒸馏、量化、剪枝这些技术,把参数压到原来的1/10甚至1%,让它能在边缘芯片、甚至手机上跑。现在你手机里的离线语音助手、本地修图软件,背后都是这类优化后的小DL模型。
说实话,前两年那种拿个能聊天的DLDemo就能拿千万融资的好日子,早就结束了。现在投资人见DL创业团队,第一句话根本不问你模型准确率多少,只问三个问题:推理单次成本多少钱?数据从哪来?客户为什么要给你付钱?
现在上游的GPU出租价格,比2022年的高点降了快40%,很多之前靠卖算力赚快钱的中小云厂商,已经开始亏钱了。
真正能跑通的DL应用:从来不是那些喊得最响的
你会发现一个很有意思的现象:媒体上吹得最凶的DL应用,比如通用聊天机器人、全自动驾驶、AGI,反而商业化进展最慢;那些没人宣传的、看起来很”土”的场景,反而已经踏踏实实赚了好几年钱。比如电商平台的商品图自动生成。
原来一个淘宝中小商家,拍一套主图加详情页,找美工修图,最少要花几百块,等好几天。现在用DL生成,输入产品的照片和想要的风格,几秒钟就能出一套图,成本不到一毛钱。珠三角很多做服装、小商品的商家,现在已经把80%的主图都换成DL生成的了,根本没人对外说。
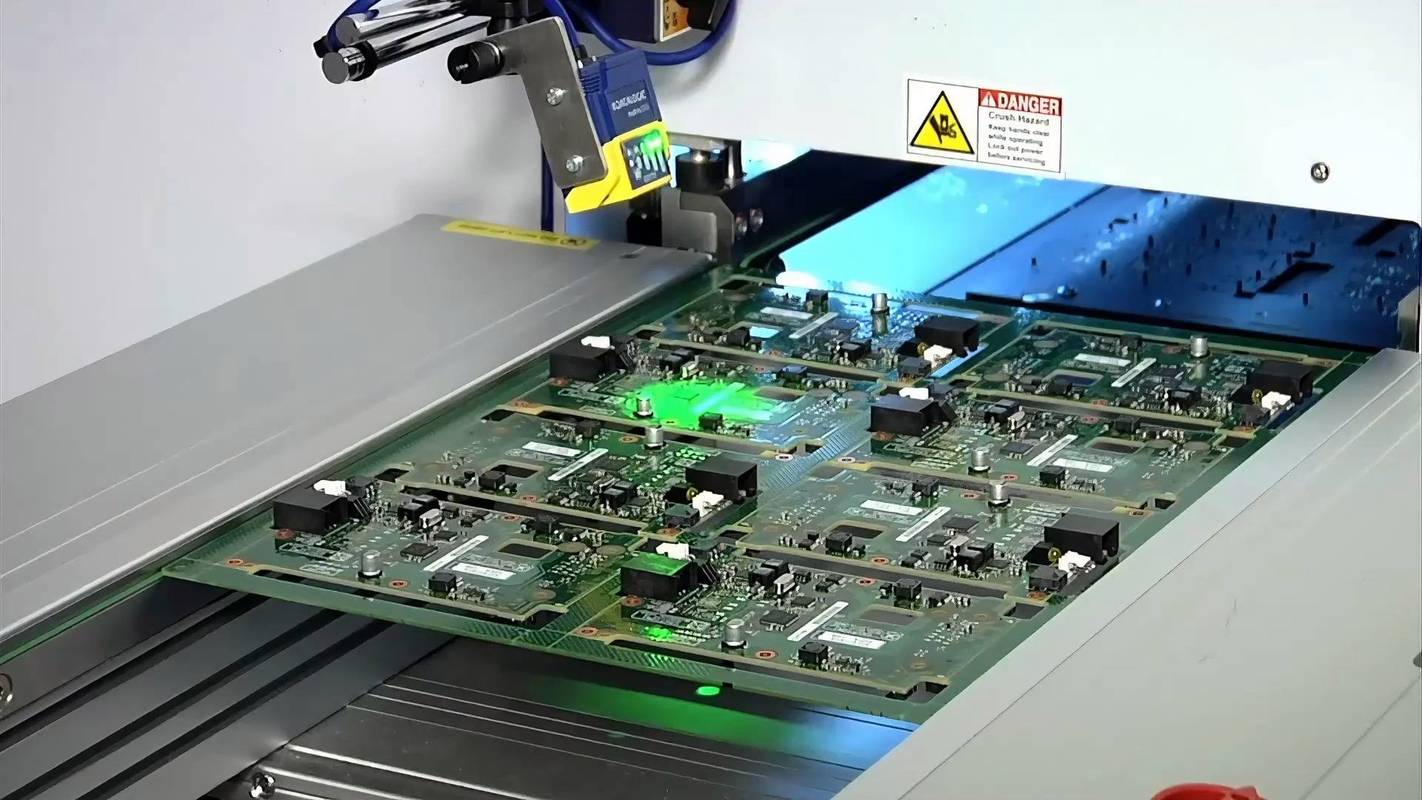
还有工业场景的PCB缺陷检测。
原来工厂里招质检员,一个人一天看几千块电路板,看久了眼睛花,漏检率能到5%。现在用DL相机扫板子,几毫秒就能找出划痕、虚焊的缺陷,准确率能到99.9%,已经在长三角、珠三角的PCB工厂铺了快三年了。
别不信。
去年我认识的一个做DL工业检测的创业公司,给某汽车零部件厂做项目,光帮客户整理过去十年的生产数据、标注缺陷样本就花了6个月,最后核心模型的开发只花了2周。很多人说DL落地难,难的根本不是模型本身,是传统行业根本没有整理好的可用数据。
没人愿意提的DL暗面:数据、伦理与看不见的成本
DL跑的越顺,背后的暗面就越明显。首先是数据版权的问题。现在绝大多数DL模型的训练数据,都是直接爬的互联网上的公开内容——小说、文章、图片、视频,根本没经过原作者授权。之前已经有不少作家、摄影师起诉AI公司,说自己的作品被用来训练模型,却没拿到一分钱分成。国内现在还没有明确的法律条文,界定这种训练行为算不算侵权,等于整个行业都在灰色地带跑。
然后是隐私泄露的风险。很多做DL人脸识别、用户行为分析的公司,手里握着几百万甚至上千万用户的人脸、消费记录数据,之前已经出过好几次数据泄露的事,这些数据一旦被拿去做黑产,后果不堪设想。
还有一个最容易被忽略的长期成本:模型的迭代成本。
很多客户一开始听DL能省人力,觉得特别划算,签了合同才发现:模型不是训完就一劳永逸的。产品外观变了、用户喜好变了、生产工艺改了,原来的模型准确率就会掉,就得重新标注数据、重新训练,每年要付几十万甚至上百万的运维费。不少客户做了一年就反应过来,自己花的钱比原来请人还贵。
聊到这,其实很容易对未来3-5年的DL产业做几个很实在的判断,没有什么虚头巴脑的概念:
第一,通用大模型的参数竞赛会彻底停掉。接下来大家拼的根本不是谁的模型参数多,是谁能把推理成本降到最低——谁能把DL模型处理一条数据的成本降到现在的1/10,谁就能拿下绝大多数的行业订单。
第二,DL会彻底变成像水电一样的基础设施。再过3年,你做个电商后台、做个小程序、做个小的工业系统,根本不需要自己养算法团队,直接调用现成的DL接口就行,就像现在你用云服务器一样简单。
第三,会冒出来一批专门做”DL落地最后一公里”的公司。这些公司不做大模型,不搞参数竞赛,就是帮传统行业整理数据、适配场景、做长期运维。这些公司的盈利能力,会比那些天天喊通用大模型的公司强得多。
最后说句掏心窝子的话。
技术从来都不是目的。
那些能真的帮工厂省成本,帮商家多卖货,帮普通人省时间的DL,才是真的有价值的DL。那些天天吹AGI马上要取代人类的,要么是没接触过真实的产业场景,要么是想割投资人的韭菜。
就这么简单。
作者|大讲堂
排版|大讲堂
审核|阿辰