 大讲堂

端侧跑分杀出来的黑马
没人提RNN了。
早在2017年Transformer论文出来之后,做序列建模的人一拥而上全转了方向,剩下啃RNN的,不是没项目转的老教授,就是找不到新方向的硕士生。业内聊起RNN,语气跟聊软盘、BP机差不多,都是被扫进历史垃圾堆的旧东西。
结果2026年开年,国内AI终端产业联盟办的端侧大模型跑分赛,出事了。冠军是个名不见经传的小团队,拿出来的1.3B参数对话模型,用的就是改了结构的RNN,直接干翻了三家大厂送测的Transformer同参数模型。
我去翻了跑分表,数据吓一跳。同是1.3B参数,RNN架构的推理速度比Transformer快2.3倍,功耗降了62%——相当于一台千元安卓手机跑一天AI对话,只消耗掉刷1小时短视频的电量,同性能Transformer模型半小时就能掉20%的电。
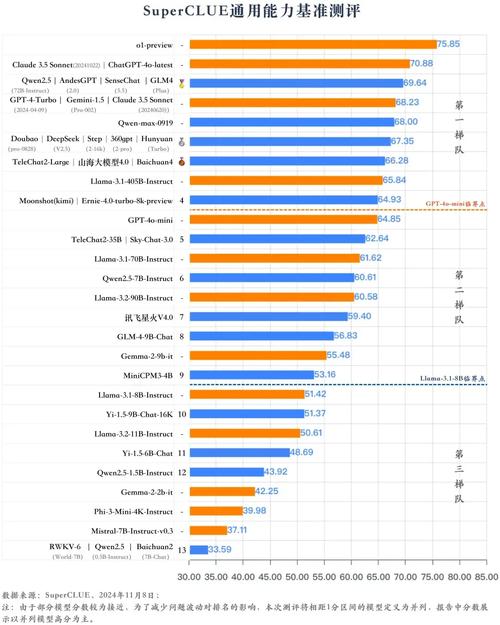
说实话,我看到这个结果第一反应不是惊喜,是恍然。原来大家都默认旧技术死了,没想到只是换了个赛场活过来了。这两年全行业盯着云侧大模型卷参数,堆到万亿还不够,谁有空管端侧那点小需求?可用户需要啊,你拿个手机,出门没信号就不能用AI,那叫什么智能设备?车上的AI,一跑对话就卡导航,谁会买账?
很多人说RNN天生缺陷,不能并行,训练慢,长上下文记得住吗?这次冠军模型能跑256k上下文,比绝大多数移动端Transformer模型支持的上下文都长。脸疼吗?
旧架构翻红的底层账
说实话,当年Transformer出来干翻RNN,赢的不是逻辑,是训练并行性。云侧训大模型,要的就是几百张卡一起跑,RNN得一句一句顺序算,当然比不过。可现在到了端侧,场景反过来了,不需要你天天训模型,只需要你天天推理,RNN天生顺序推理,不需要存大堆KV缓存,刚好踩中了需求。
放在生物进化里看,这个逻辑太好懂了:长颈鹿的长脖子是开阔草原的优势,但是放到密林里,长脖子反而容易卡树杈,原来被淘汰的短脖子性状,放到新环境里又成了生存优势。RNN就是那块被扔在演化垃圾桶里的短脖子,现在端侧这片密林长出来了,它刚好合适。
不过话说回来,国内大厂早就偷偷在用了,只是没人公开说。字节跳动早年做短视频用户推荐,就是用RNN做行为序列建模,后来全栈转了Transformer,现在抖音的端侧AI搜素,已经悄悄换成了改良后的RNN架构,为什么?端侧搜素要秒出结果,不能等云端回传,RNN的低延迟刚好满足。还有国内做车规AI芯片的地平线,去年出的征程6芯片,内置的整车交互模型用的就是RNN,车机内存就那么大,还要留空间给导航和自动驾驶,容不下Transformer那堆占内存的KV缓存。
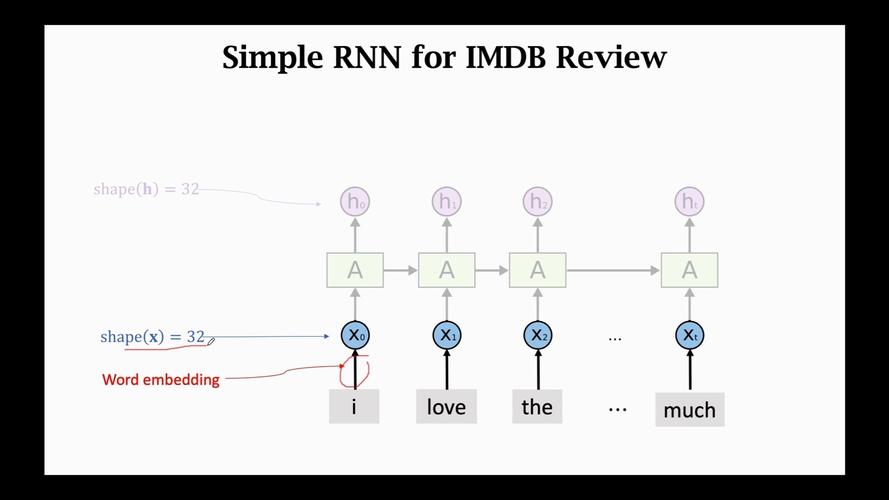
我给算笔账,支持128k长上下文的RNN模型,内存占用比用KV缓存的Transformer少了70%,同样8G运行内存的车机,RNN能同时扛住导航、AI交互、后排娱乐三个大应用不杀后台,Transformer只能留一个,剩下的全得强制退出。这就是实打实的用户体验差距,不是什么虚的技术领先。
为什么现在才翻红?全行业都在骗自己啊。前几年大模型热,所有人都盯着千亿参数挤赛道,融资要讲Transformer的故事,发论文要蹭Transformer的热点,你说你做RNN,投资人转头就走,觉得你不懂趋势。可卷到现在,云侧大模型的钱都被英伟达和几家巨头赚走了,中小厂商连汤都喝不上,才回头看,原来端侧这片蓝海,早就给RNN留好了位置。
产业链的鲶鱼已经放进来了
很多人觉得,RNN翻红就是架构圈的自娱自乐,跟普通从业者没关系。错了。这是给整个产业链放了一条鲶鱼,最先受益的就是中小创业者和垂直领域的开发者。
之前你要做一个垂直领域的大模型,比如做汽修故障诊断,做餐饮门店私域AI,训一个7B参数的Transformer,光云算力成本最少三十万,还得有懂调优的算法工程师,小团队根本拿不出这个钱,只能基于大厂的API做二次开发,赚点辛苦钱,命脉还捏在别人手里。现在呢?改良好的RNN架构,训练成本只有同参数量Transformer的五分之一,几万块就能训一个符合你需求的垂直模型,完全部署在自己的服务器甚至终端上,不需要给大厂交年费,也不用担心哪天API涨价你就活不下去。
我上个月见了一个做家政AI培训的创业者,原来打算花几十万租算力训Transformer模型,后来听了朋友建议试了RNN,最后花了不到八万就训出了能用的模型,效果比同参数Transformer还稳定,因为家政培训的对话都是线性流程,RNN对顺序信息的捕捉反而更准。他现在把模型直接装在代理商的平板里,不需要联网就能用,代理商的成本一下子降了三分之二,卖课比之前好做多了。
对芯片厂商来说也是机会,原来做AI芯片都盯着云端训练芯片的指标堆算力,几万亿晶体管堆上去,一块卡卖几万块,中小公司根本买不起。现在端侧RNN模型对算力的要求低很多,很多国内的中端芯片就能跑,不需要依赖最先进的3nm工艺,也能做出能用的AI终端,这给很多二线芯片厂商留出了生存空间,不用死磕最先进的工艺跟巨头拼产能。
全行业都在喊卷不动了,都在找新的增长点,可所有人都盯着Transformer的独木桥挤,没人敢回头看看被扔在路边的旧技术。RNN这波翻红,本来就是给所有人提了个醒。
当全行业都在千亿参数的赛道上挤得头破血流,你敢不敢回头,去捡那块被扔了十年的旧拼图?
作者|大讲堂
排版|大讲堂
审核|小北