2026-09-26 23:27:51 分类:科技
去年跟某股份行科技部的老陈聊天,他拍桌子说的一句话我现在还记得。
“有数据的不能建模,能建模的没数据,合个模还要把原始数据送出去?谁敢?”
这不是个别案例。国内数据要素流通喊了这么多年,真正跑通的跨机构联合建模项目,十个里面有七个卡在了模型聚合这一步。很多人吹联邦学习能解决数据孤岛,却很少把聚合这块的坑摊开了说。
模型聚合,是隐私计算联邦学习的核心命门
联邦学习的本质是“数据不动,模型动”,多个参与方联合训练模型,全程不交换原始数据,只交换模型参数或者梯度信息,最后把这些信息汇总成一个通用模型——这个汇总的过程,就是联邦学习模型聚合。
很多人觉得聚合不就是做个加权平均?有什么难的?说实话,绝大多数开源联邦学习框架里,默认的聚合算法确实就是简单的加权平均。但实际产业落地里,这里的水太深了。
横向联邦、纵向联邦、联邦迁移学习,不同框架的聚合逻辑天差地别。横向联邦面向同特征不同样本的场景,比如同区域不同银行的客户数据,聚合的是各家训练出来的模型参数;纵向联邦面向同样本不同特征的场景,比如银行有交易数据、互联网公司有行为数据,聚合的是计算过程中的梯度信息。
 横向联邦学习模型聚合流程示意图
技术边界很清晰:聚合环节是整个隐私保护的最后一道闸门,也是性能平衡的核心节点。你加的隐私保护越多,对模型精度的影响就越大;你为了降通信开销砍参数,模型效果又会掉。所有的矛盾都集中在这。
举个最常见的坑:十家机构参与联合建模,每一轮训练都要传输一次参数,模型大一点,一轮就是几个G,训一百轮下来,专线都能给你卡爆。很多项目测试的时候跑得好好的,一上生产环境就因为通信超时崩溃,问题全出在聚合的方案设计上。
还有更头疼的安全问题。你以为不发原始数据就安全了?早就有研究证明,只要拿到聚合过程中的梯度信息,就能反推出参与方的原始训练数据。很多小厂商的方案,连最基础的梯度扰动都做不利索,还敢吹自己是绝对安全。
产业界现在的进展,比你想的更务实
这两年国内隐私计算厂商抢项目,核心拼的就是模型聚合的优化能力。
最常见的优化方向是剪枝压缩。只传有用的参数,不重要的参数直接剪掉再聚合,通信开销能降一半以上,对精度的影响能控制在1%以内。还有把聚合和可信执行环境(TEE)结合的,把整个聚合过程放在加密的可信区域里做,参与方只进不出原始参数,聚合完的结果再放出来,安全等级一下子就上去了。
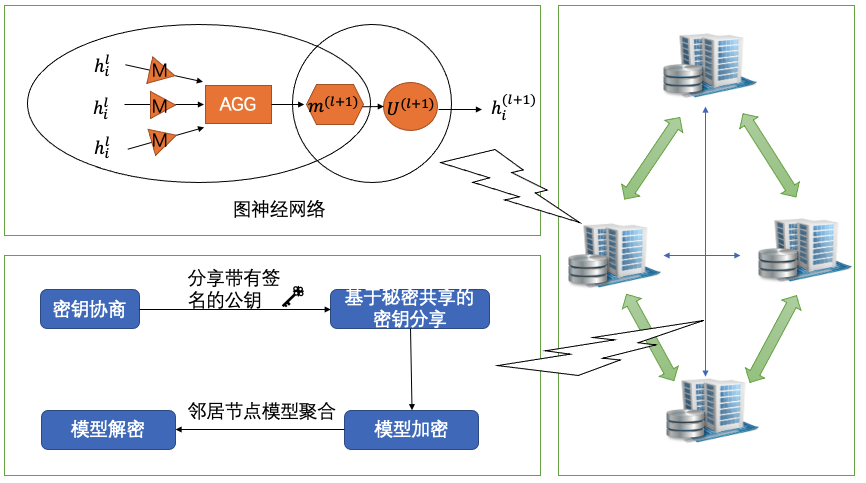 联邦学习聚合节点TEE可信执行环境架构图
现在落地最多的场景还是金融反欺诈和政务数据开放。某长三角政务数据开放平台,现在就是用这种TEE加聚合的方案,让银行调用政务数据训练模型,政务数据不出去,银行原始客户数据也不出去,只在聚合节点合模型,一年下来已经跑了上百个模型,没有出过一次隐私泄露事件。
金融领域更直接,多家城商行联合训练的反欺诈模型,聚合后的效果比单家训练的准确率高了近30%,坏账识别率提上来,一年能少损失几个亿,大家都愿意玩。
不过话说回来,现在能落地的项目,九成以上都是横向联邦的模型聚合。纵向联邦的聚合,现在还是一堆坑没填上。不同机构的特征对齐之后,交叉梯度的聚合,既要保安全又要保精度,现在还没有哪个厂商的方案能做到完美适配所有场景,很多项目测了大半年,还是不敢上生产。
产业链现在的分化也很明显。头部厂商把核心研发力量砸在聚合算法优化上,拿大项目的时候一拿一个准;中小厂商大多是改改开源框架的聚合模块,拼价格抢小单子,核心技术根本拿不出手。
绕不开的治理问题,未来三年的走向
 绕不开的治理问题,未来三年的走向
现在模型聚合这块,最大的风险不是技术,是规则和治理。
第一个风险是投毒攻击。多个参与方联合建模,只要有一家作恶,给本地模型注入后门,聚合之后整个全局模型都会被污染,而且因为聚合过程中大家都看不到对方的原始参数,根本查不到是谁干的,出了问题只能所有人一起背锅。现在还没有哪个通用方案能完全解决作恶节点检测的问题,大项目做的时候,只能提前把参与方资质卡得很严,把作恶的概率降下来。
第二个问题是标准不统一。不同厂商的聚合接口、加密算法都不一样,你用A厂商的框架,我用B厂商的,我们俩根本没法一起做联合建模。等于说,原来的孤岛是数据孤岛,现在变成了隐私计算平台的孤岛,太讽刺了。
第三个是伦理问题。聚合出来的模型,所有权归谁?出了问题责任怎么分?现在没有任何一条规则说清楚,很多机构本来想做联合建模,一想到这个权责问题,直接就停了。
对未来三到五年的判断,其实很清晰。
第一,统一标准一定会出来。现在国内已经有机构在做模型聚合的接口标准和安全等级标准,不出三年,主流厂商的平台一定会做到互联互通,不然整个行业都没法做大。
第二,大模型联邦微调会带火一波聚合技术的升级。现在很多机构都在做多机构联合微调行业大模型,大家都不想把自己的私有数据拿出来,只能靠联邦学习,模型越大,对聚合的通信效率、安全要求就越高,这块的技术升级会非常快,明年就能看到一大批落地项目。
第三,中小玩家会被淘汰出局。模型聚合这块真的靠堆技术堆人才,改开源拿不到大项目,迟早会被洗掉,最后留下的,也就那么三五家核心玩家。
说白了,数据要素流通的底座是隐私计算,隐私计算联邦学习的核心就是模型聚合。这块卡着,整个数据要素市场都转不快。啥时候把聚合的坑填上,数据才能真的变成可流通的生产要素。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:隐私计算联邦学习模型聚合:产业落地卡在了哪
文章链接:https://m.lfdjt.com/info_23_22170.html
 大讲堂
