2026-09-18 19:02:48 分类:科技
去年跟一个电商公司的技术负责人吃饭,他拍着桌子吐槽,说前几年为了做实时数据报表,团队养了三波人:一波做离线批处理,一波做实时流计算,还有一波专门天天对账——就因为两边算出来的GMV永远对不上,差个几十万是常事,大促的时候运营天天堵在工位门口要数。
搞了十年,流和批为什么非要绑在一起
最早的大数据架构,本来就是流和批分家的。
大家默认,需要低延迟的实时场景用流计算,要全量精确计算的离线场景用批处理,两套引擎两套存储两套开发逻辑,相安无事很多年。直到后来Lambda架构出来,试图把两者结合,结果呢?本质还是“流批各干各的,最后结果拼一下”,开发要写两套代码,运维要管两套集群,数据出问题要查两遍。
说白了就是,需求变了,老架构跟不上了。
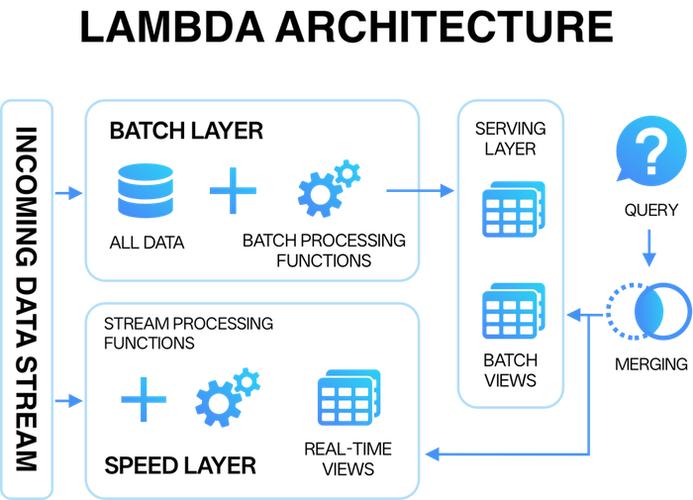 传统Lambda大数据流批分离架构图
流批一体的核心逻辑说穿了一点都不玄乎——一份数据,一套引擎,同时支持流计算和批计算。原来你要给用户打兴趣标签,离线要算一遍全量,实时要算一遍增量,逻辑改一次两边都要更,现在写一遍逻辑就行,不管是实时更新还是全量校准,都用同一套代码跑。
说实话,这个需求从来不是技术圈自嗨造出来的概念。完全是业务逼出来的。
现在哪个行业不需要实时数据?直播要盯实时GMV,网约车要调实时派单,电商要做实时推荐,广告要算实时投放转化,你让用户等第二天再看结果,生意都没了。但原来两套架构的维护成本,真的太高了,中小公司根本养不起两拨人折腾这个。
真落地了吗?哪些坑已经踩出来了
现在行业里的情况很有意思,头部公司玩全链路,中小公司玩半吊子,还有不少公司停留在概念测试阶段。
最早把流批一体落地到大规模场景的,国内要数阿里,海外是谷歌、Netflix这类公司,现在以Flink为代表的引擎已经把计算层的统一做的差不多了,主流的云厂商也都推出了托管的流批一体服务。
举个真实的例子,某头部电商618大促,原来实时大屏的数字和最后离线结算的数字总能差出上百万,运营要花一整夜对账,现在用流批一体,实时计算的结果可以直接复用,离线只需要做最终校准,不用全量重跑,对账时间从十几个小时缩到十几分钟。
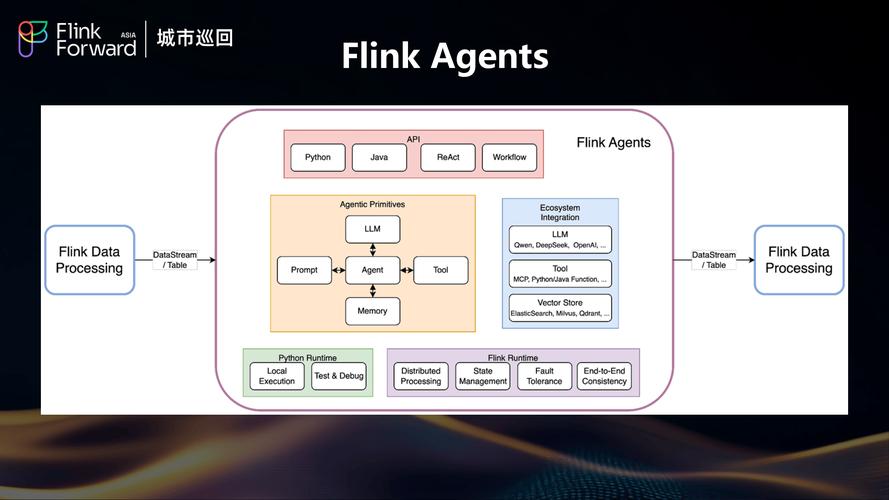 基于Flink的流批一体大数据平台架构图
不过话说回来,现在流批一体的坑真不少。
最大的瓶颈不在计算层,在存储层。很多公司想做流批一体,计算改成一套了,存储还是原来的老样子:流数据存在消息队列,批数据存在数据仓库,湖仓一体的存储格式没搭起来,最后还是免不了数据要来回导,本质还是换汤不换药。
还有改造的成本问题。你让一个已经跑了五六年离线数仓的公司,全部推倒重来上全链路流批一体?谁敢拍这个板?改造成本可能比重新建一套还高,大部分公司都是慢慢迁,先把核心业务迁过去,老业务慢慢跑,也就这样了。
还有人才的坑,原来流和批是两个岗位,现在合在一起,数据开发既要懂实时又要懂离线,门槛高了不少,很多公司团队能力跟不上,上了流批一体,出了问题排查半天,反而比原来效率更低。
未来三年,流批一体会变成标配吗
 未来三年,流批一体会变成标配吗
我接触过的不少大数据从业者,都觉得流批一体是接下来大数据架构的必然方向,这个我同意,但也没那么快。
未来三年,首先会发生的是,流批一体会从头部公司往中小公司渗透。原来中小公司玩不起,现在云厂商的托管服务越来越成熟,不用自己搭集群运维,按使用量付钱,成本降了一大截,很多原来用两套架构的中小公司,会慢慢迁过来,核心目的就是降本增效——毕竟养两个团队的钱,够给云厂商赚还能剩不少。
然后,原来的离线数仓市场会被慢慢侵蚀,越来越多的新数仓都会 built-in 流批能力,纯离线的数仓服务,只会越来越少,最后只会留在一些对延迟没要求的传统行业场景里。
当然风险也很明显,现在很多公司盲目追热点,上来就全量改流批一体,最后钱花了几百万,效果还不如原来的老架构。技术从来都是匹配业务的,如果你是做传统报表,每天出一次就行,犯不着凑这个热闹。
另外,流批一体带来的数据治理挑战,现在还没被充分重视。原来流和批分开,权限、监控、容灾都是两套,现在合在一起,出问题就是全链路的问题,排查难度翻了倍,很多公司上了之后才发现,自己的治理能力根本跟不上,数据错了都不知道在哪错的。
实话讲,未来三到五年,流批一体会变成大数据架构的标配,就像当年分布式取代单机架构一样,但真正做到百分之百全链路统一的公司,依然只会是少数,大部分公司都会处于“核心业务流批,边缘业务还是老批处理”的状态,这才是最真实的产业状态,不是吗?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:流批一体:大数据架构的十年折腾,终于走到哪一步了?
文章链接:https://m.lfdjt.com/info_23_20521.html
 大讲堂
