 大讲堂

从「能说会道」到「能看会听」:到底什么是多模态大模型
说实话,现在90%吹多模态的行业PPT,我看完都想揉成废纸扔垃圾桶。 很多人连单模态大模型都没用明白,就把多模态吹成了无所不能的万能解药。说白了,单模态大模型只能处理一种类型的信息,要么是文本,要么是图像,而多模态大模型,能同时理解、生成、处理至少两种不同类型的信息——文字、图像、音频、视频、传感器信号,都能揉到一起处理。 核心原理说穿了也不复杂,就是做「对齐」。把不同类型信息的语义,映射到同一个公共语义空间,让模型能明白「猫」这个文字,对应图片里那只四条腿会喵喵叫的动物,也对应音频里的猫叫。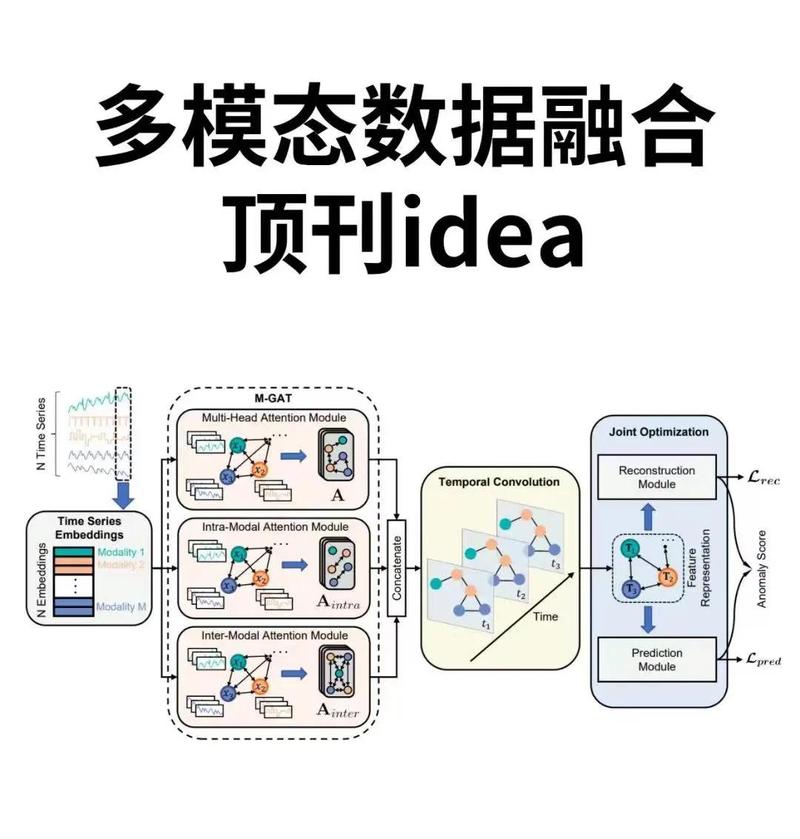
产业落地:哪些赛道真跑通了
现在圈里有个很有意思的现象:骗融资的都在做通用多模态,真赚钱的都在扎垂直场景。 我接触过的几家跑通现金流的公司,都没喊什么「通用人工智能」的口号,反而闷声在细分场景赚了钱。 第一个跑通的是工业检测领域。传统的缺陷检测AI,只能看图像,要是遇到需要结合检测文档、工件参数来判断的场景,就得人工补流程。多模态大模型能同时看零件的实拍图,读对应的生产文档,识别工人的语音录入,一次出检测结果,准确率比传统AI高15%以上,还能省掉一半人工。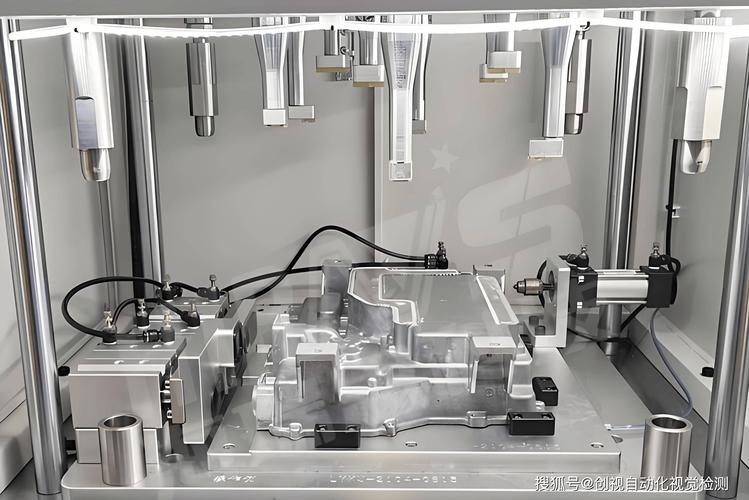
热钱之下,被遮住的真问题
未来三年:产业格局会变成什么样
作者|大讲堂
排版|大讲堂
审核|安然