你有没有过这种经历?搜了一次冷门体检项目,接下来大半年打开所有APP全是相关广告。 甩都甩不掉。 你说烦不烦。
我们想要APP懂我们,给我们推刚好需要的东西,可我们不想把自己的就医记录、消费习惯甚至家住哪全给出去。对吧?
之前大厂之间想合作搞更准的推荐,都得拿着数据交换,你给我我的用户数据,我给你你的,一换就是风险,搞不好就触了监管红线。现在呢?很多合作已经不用交换原始数据了——这背后干活的,就是今天要说的这个东西。
你天天用它,却多半没听过名字
说个真实的场景。一个普通人去银行申请经营贷款,银行需要知道他最近一年的流水和纳税记录对不对?这些数据都在税务部门,税务部门能把所有企业的纳税数据直接给银行吗? 肯定不能。 那以前怎么操作?要么让申请人自己跑去税务开纸质证明,来回跑两三天,要么银行对接接口,拿了全量数据回去算,风险全在银行这边,一不小心就出泄露。
现在用隐私计算怎么干?银行把申请贷款的用户ID加密发给税务,税务在自己的服务器上算出这个用户符合不符合贷款资质、应该给多少额度,把结果加密发回给银行,全程银行拿不到税务手里任何其他用户的原始数据,税务也拿不到银行手里用户的其他信息,双方都拿到了想要的结果,谁都没碰对方的原始数据。
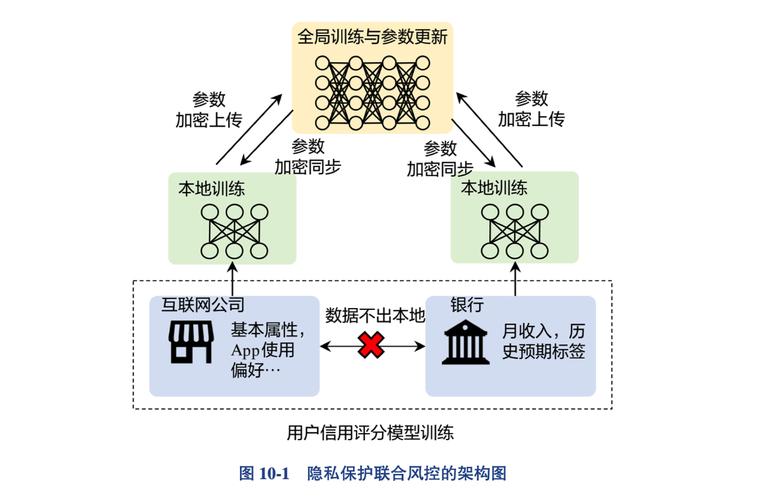
不止金融。你现在刷短视频的个性化推荐,平台之间联合做广告投放,甚至医院联合研究新药的病例数据,都能用这个。
很多人一听到隐私两个字,就觉得这是给普通人加的保护锁,说白了就是不让平台拿我数据。其实不对,它真正的作用是盘活数据,又不踩红线。以前大家手里都有数据,不敢拿出来用,也不敢交换,现在好了,价值能拿出来用,数据还是留在自己这。
别被术语吓住,核心逻辑三岁能懂
一讲隐私计算,很多文章上来就甩联邦学习、安全多方计算、同态加密一串术语,看完直接劝退。说实话,核心逻辑一点不复杂,举个例子就懂。
你和你的同事都想知道你们俩谁的工资更高,但是你们都不想告诉对方自己具体拿多少钱。怎么办?
放在以前,要么两个人都把工资条摊开,谁都知道对方赚多少,要么永远比不了。隐私计算的做法是,你找一张纸条,写上你自己的工资加一个只有你知道的随机数,折起来给同事,同事也写一张自己工资加一个只有他知道的随机数给你。你拿到同事的数,加上你自己的真实工资,减去你加的那个随机数,给回同事,同事减去他加的随机数,就得到了两个人工资总和,对比一下就知道谁高谁低。
全程。你不知道同事的真实工资。同事也不知道你的。 但是你们都得到了想要的答案。
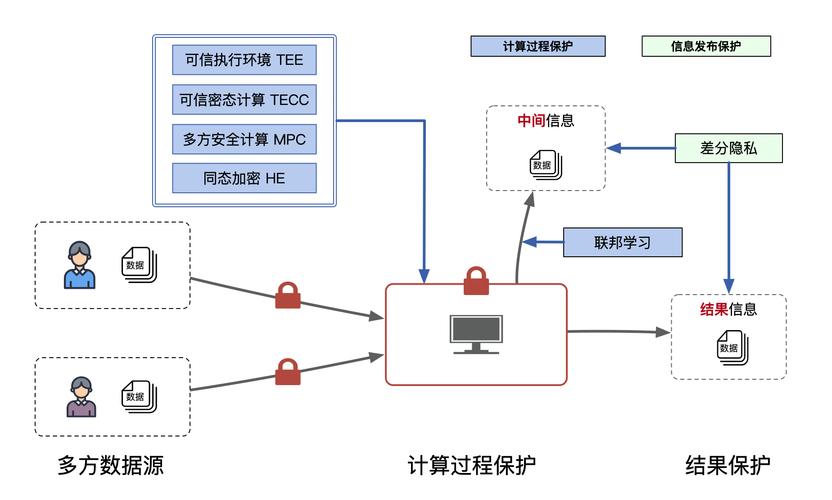
就这么简单。那些复杂术语,本质就是给这个逻辑套上更安全更高效的加密算法而已,核心没变:能用数据的价值,拿不到数据本身。
不过话说回来,很多人对隐私计算有个挺大的误区,觉得它就是加密存储对不对?不对。加密存储是说我把数据锁起来,不用的时候没人能看。隐私计算是说,我用你的数据的时候,也不用打开锁看到原始数据,直接就能算出来想要的结果。完全两码事。
还有人说,那我把数据都匿名化不就行了?匿名化其实不安全,只要多个数据凑一起,很容易就能把匿名的数据对应到具体某个人身上。隐私计算从根上就没把原始数据拿出来,也就不存在这个问题。
吹得神乎其神,其实还有不少坑
说实话,现在资本炒概念,一堆厂商把隐私计算吹成解决所有数据问题的神药,其实根本不是这么回事。我接触过几个做这个方向的工程师,吐槽都吐不过来。
第一个坎就是慢。原来所有数据都放在同一个服务器里,算完一秒出结果。隐私计算要多个不同机构的服务器之间来回传加密后的中间结果,一来一回,速度比原来慢几倍甚至几十倍。要是数据量特别大,比如几十万用户的特征计算,等你算出来,投放窗口都过了。现在很多算法都在优化速度,但是离像传统计算一样快,还有不小距离。
第二个坎,没有绝对的安全。很多厂商说我们的隐私计算绝对不会泄露数据,这话听听就算了。现在已经有研究证明,哪怕你不拿原始数据,也可以通过多次计算的结果反推出原始数据的信息,尤其是如果某个细分样本只有很少几个人,甚至一个人,反推的成功率特别高。当然现在算法也在补这个漏洞,但还做不到100%。
第三个坎,成本太高。一套隐私计算平台搭下来,小公司根本用不起。哪怕租着用,每年的服务费也不是小数。很多小商家小平台本来就没多少数据,犯不上花这个钱。
那说了这么多,隐私计算是不是就是个骗投资的概念?当然不是。监管越来越严,大家对数据泄露越来越敏感,原来那种“拿数据换体验”的路子已经走不通了。用户想要个性化的服务,又不想隐私被泄露,这个需求是真的,那隐私计算就是刚好卡在这个节点上的技术。
以后说不定哪天,你想领商家的新用户优惠券,不用再授权商家读你的通讯录和地理位置了,商家只要通过隐私计算确认你是第一次来,就能给你优惠,你的信息半毛钱都不会给出去。想想是不是比现在爽多了。
它不是什么神药,但是它给了我们另一种选择:不用在“被裸奔”和“用不了好服务”之间二选一。 这就够了。
作者|科技
排版|科技
审核|乐乐