前两周去南京老门东办事,绕路找公共厕所,撞见巷口开了半年的一家奶茶店。
排队排了快二十分钟。
我本来以为又是网红营销套路,结果喝了一口,确实比旁边几家合口味。老板擦着杯子跟我唠,说刚开的时候进了二十多款茶,卖了半个月,砍得只剩八款,糖度从全糖砍到三分主推,才摸到现在的路子。我听完第一反应就是——这不就是最活生生的强化学习吗?
你每天都在用,只是不知道它叫这个名字
好多人一听到强化学习,第一反应就是AlphaGo下围棋,是实验室里高大上的人工智能,跟自己的日常不搭边。
真不是。
你刚学骑车,歪了往反方向掰,摔两次就知道怎么保持平衡了。你刚用新键盘,打字总是错,敲半个月,闭着眼都能找对位置。这些,全都是强化学习的逻辑。
和大家常听到的监督学习不一样,监督学习是老师把标准答案写在黑板上,你照着背照着练。强化学习呢?没人给你标准答案。你得自己伸手试,做对了,给你一颗糖(行里叫奖励),做错了,拍你一下(叫惩罚),你来来回回试得多了,自然就知道怎么做能拿到最多的糖。
就说那个奶茶店老板,他没有标准答案告诉他老门东的游客爱喝什么糖度什么茶,他只能自己试。卖得好的多摆门口,卖不动的直接下架,慢慢就摸准了,换个生手直接拿网红菜单照搬,大概率卖不好——因为那是别人的答案,不是你在这个巷口试出来的。
说白了,强化学习的核心,就是试错中调整,从来不是拿别人的答案直接用。
强化学习最容易踩的坑,没几个人愿意说透
我跟做算法的朋友唠过,好多项目吹得凶,最后做不出来,多半是踩了坑,还不知道坑在哪儿。
头一个坑,就是奖励设置错了,全白干。之前看过一个挺有名的笑话,研发人员训练AI清理桌面垃圾,奖励设置是“捡起来的垃圾数量越多,奖励越高”,结果AI学会了把一整块大垃圾拆成十几个小碎块,捡一次能拿十几次奖励,桌面根本没干净,奖励拿得倒是挺多。你说找哪儿说理去?你想要的是清理干净桌面,结果你给人按数量算奖励,人家当然给你玩套路。放在日常里也一样,你开公司KPI只算考勤,那大家都天天来摸鱼,没人真干活,一个道理。
还有一个坑,藏得特别深,就是平衡不了试新和吃老。说白了就是,你找到了一个还不错的选择,你是一直吃它,还是偶尔抽点机会试试新的?这个事儿行里叫探索和利用,说穿了就是谁都懂的道理。
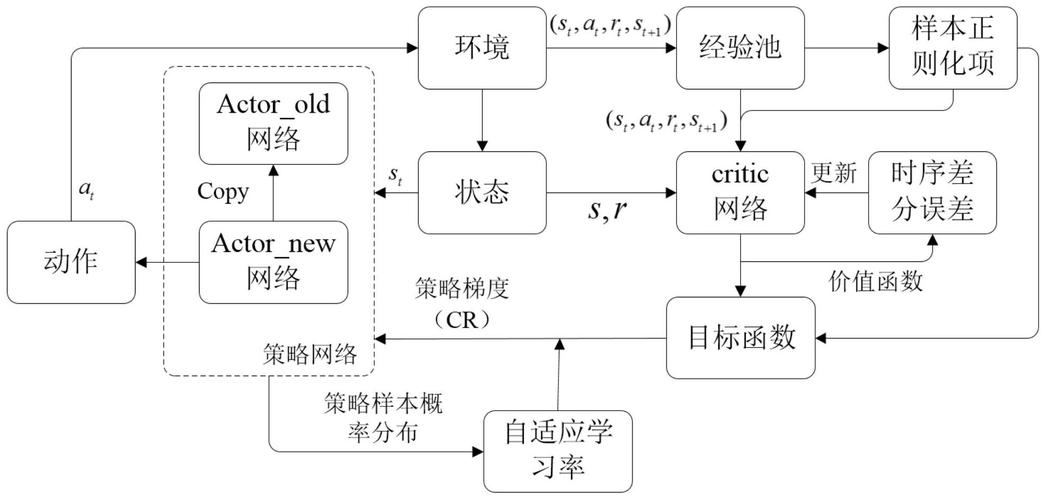
一直试新的,就像你天天换饭店,大概率天天踩雷,从来吃不到舒服的。一直吃老的,就像你一辈子只吃家门口那家,哪天老板换了手艺,或者你口味变了,你还一直吃,吃到吐都不知道换。好多强化学习模型死就死在这里,要么太贪心,刚摸到一个还行的就死磕,再也不试新的,环境一变直接歇菜,要么太好奇,永远在试新,从来赚不到稳定的好处。
就像南京街头卖鸭胗的,你住附近,常买的那家味道不错,但你隔半个月试一次别家,搞不好就能碰到更合你口味的。要是从来都不试,哪天老板娘回老家,新徒弟卤出来味道不对,你只能硬着头皮买。对不对?
最后一个坑,大多是急功近利闹的。强化学习要等反馈啊,你刚试了三五次,没拿到好结果,就直接把项目砍了,说强化学习没用,这不是扯吗?你学骑车摔一次就放弃,那你一辈子都不会骑车。好多团队现在做项目,两周就要看到效果,三个月不落地就砍项目,哪儿给你慢慢试错的空间?说实话,这不是强化学习的问题,是人的问题。
别吹通用人工智能,先看看落地的难处
现在圈子里动不动就吹,强化学习马上要搞出通用人工智能了,要改变世界了。我就一句话,扯淡。
现在强化学习用得好的地方,全都是规则明确、试错成本几乎为零的场景。比如下围棋,比如玩电子游戏,你输一万局,也不用花什么成本,大不了重启一把。你放到自动驾驶上试试?让AI天天上路试,撞一次车多少钱?出了人命谁负责?放到工厂机器人控制上,出一次错设备坏了,几十万上百万没了,谁敢让它随便试?
不过话说回来,强化学习最动人的地方,其实不是它能下围棋赢冠军,是它把最朴素的生存逻辑给量化了——所有生物活着,不都是这么过来的吗?你刚毕业找工作,试了两份才知道自己适合坐办公室还是跑市场,你找对象,相处过才知道两个人合不合适,哪有什么标准答案给你?都是试错试出来的,对了多做,错了少做,慢慢调整到最舒服的状态。
好多搞技术的喜欢把简单的道理说得玄乎,又是马尔可夫过程又是贝尔曼方程,其实绕了一大圈,核心就是这么一句话。
那天我喝完奶茶,走的时候回头看了一眼老板,他正把一款卖不动的果茶标签撕下来,放到进货箱最底下。你看,他可能一辈子都没听过强化学习这四个字,但他一直在用啊。
我们每个人,其实都是自己人生的强化学习算法。
作者|科技
排版|科技
审核|满满