2026-10-06 01:46:10
作者:
科技
上周从南京玄武湖逛完回来,文创圈的朋友甩给我一堆东西:三张歪歪扭扭的手绘IP草稿,四五张粉丝线下见面会拍的现场图,还有两条一分钟的语音留言,说让我帮着把公仔开发方案顺一遍。
换半年前,我得先把手绘扫进电脑修掉奶茶印,把语音转成文字,再把整理好的文字丢给AI写方案。那天懒,直接把所有东西一股脑丢进了多模态大模型。
十分钟后出结果。它不仅认出草稿角落被奶茶晕开的备注“想要圆爪子”,还从现场图里抓出来粉丝围在原型猫公仔旁边说“摸起来太硬”的口型,结合语音里“想做99块钱走量款”的要求,直接改了三个线稿方案,连开模时要注意的倒角细节都标了。
我当时傻了。原来“能看懂图片听懂话”不是最核心的变化
很多人聊起多模态大模型,第一反应就是“哦,就是既能写文案又能画图的AI嘛”。
真不是这么回事。
早些年的AI,你给它一张图,它要先过图像识别模块,把图里的内容转成文字,再把文字丢给语言大模型处理,就像你去政府办事,先去一号窗口登记,再去二号窗口交材料,再去三号窗口盖章,每个窗口各干各的,中间传错信息是常有的事。
 传统单模态AI分模块处理流程图
原生多模态大模型不一样,它从训练的第一天开始,就把文字、图像、音频这些所有类型的信息,转换成了同一种通用的“语言”来理解。它不是先把图转成文字再读,是像我们人一样,看到图就直接看懂了图里的内容,听到声音就直接get到声音里的信息,不用转码这一步。
那天我朋友的手绘草稿,线条歪歪扭扭,还有一半写了一半没写的批注,换以前的AI早就识别乱了,多模态直接连猜带读把所有信息串起来,给出来的结果完全踩在需求上。这种流畅感,是之前拼插件拼出来的“伪多模态”根本比不了的。
别被营销话术带偏,这三个误区太多人踩
这段时间刷社交平台,到处都是“多模态颠覆XX行业”“设计师即将失业”的论调,我试了快俩月,发现大部分人都理解错了。
第一个误区:多模态是用来抢创作者饭碗的。
我上个月让它给我做一张“南京秋天梧桐树下蹲猫”的海报,它三分钟出了八张,每张构图配色都挑不出错,但就是没那味儿——那种风一吹梧桐叶飘下来,沾了猫一背猫毛,路过的学生随手撸了一把的松弛感,它出不来。你得把这种模糊的感觉说给它,它才能一点点调到你想要的样子。
它本质上是帮你把脑子里模糊的想法快速落地,不是替你想想法。灵感和情绪,还是得从人这儿来。
第二个误区:多模态只能用来做生成内容。
前阵子跟一个做考古的学长吃饭,他说他们队现在已经在用多模态整理几十年前的考古资料了。以前的资料,有当年拍的模糊胶片,有考古队员手写的烂笔头笔记,还有后来做口述史录的音频,散在七八个系统里,找个信息要翻半个月。
现在把这些全丢给多模态,它能直接把老胶片里模糊的器物花纹,对应到笔记里的描述,还能把口述里说的“东壁第三个龛”,精准标到照片对应的位置,光是整理资料这一块,就省了他们大半年的时间。
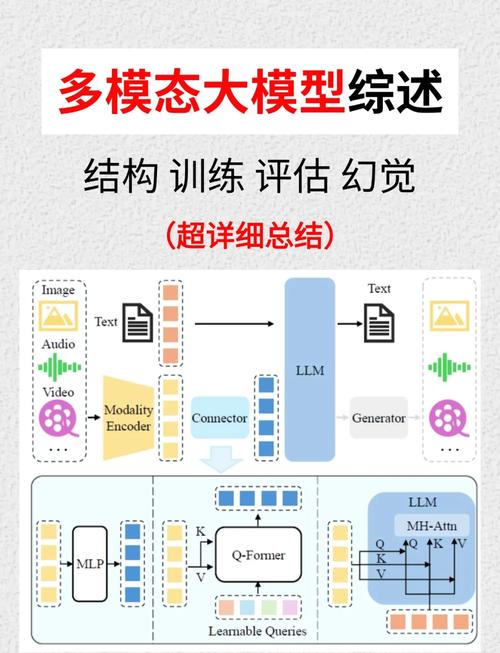 多模态大模型整理考古图文音频资料示例
这种对存量信息的挖掘,比生成新内容有用多了,只是普通人看不到而已。
第三个误区:多模态就是大模型加个绘图插件拼出来的。
市面上好多产品都打着多模态的旗号卖,其实就是在文字大模型外面接了个绘图插件、接了个语音识别插件,本质还是各干各的,跟原生多模态根本不是一回事。就像你天生就能边看边听边想,不是你的脑子后天接了个眼睛插件,对吧?
拼出来的伪多模态,你给它一张带文字的图,它经常把文字识别错,连不上上下文,原生多模态很少出这种错。
真正的改变,都藏在普通人看不见的地方
 真正的改变,都藏在普通人看不见的地方
说实话,现在大家能接触到的C端应用,其实都还在尝鲜阶段,什么生成PPT、生成短视频,都是表层的玩法。多模态真正的改变,其实在B端,在那些需要处理各种各样杂乱信息的行业。
比如医院,一个病人过来,有CT影像、有B超图、有既往病历的文字报告、还有病人自己说“我最近晚上疼得睡不着”的口述,这些信息原来散在四五个不同的系统里,医生要一个一个调出来看,光找信息就要花十分钟。多模态能直接把所有信息拼在一起,给医生整理出清晰的脉络,不是替医生下诊断,是帮医生省出更多时间跟病人聊天。
不过话说回来,现在的多模态问题也真不少。我前几天瞎试,把我家猫摔碎的碗拍了张糊图给它,它硬说这是战国时期的青瓷碗,还给我编了一堆出土地点,逗得我不行。幻觉问题,多模态比纯文字大模型严重多了,毕竟图像本身的歧义就比文字多,一块黑影子,它可以说是猫,可以说是耳机,也可以说是石头,全靠训练数据猜。
很多人炒概念,说通用AI马上就要来了,我觉得还差得远呢。现在的多模态,也就刚学会“同时看懂好几种不同类型的信息”,离真正像人一样,看到一幅画能感受到画家当时开心还是难过,听到一句话能get到你话里藏的情绪,还差十万八千里。
我最近最大的感受是,大家对AI的态度总是走极端,要么怕得要死,要么吹得飞起,其实多模态大模型最棒的一点,说穿了就是:终于不用我们人类迁就AI了。
以前用AI,你得把你的想法整理成规规矩矩的文字,说不清楚AI就听不懂。现在你可以甩给它一张随手画的破图,甩给它一段没头没尾的语音,它就能懂你要什么。
就这一点改变,已经足够慢慢撬动好多原来做不了的事了。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:我用多模态大模型改了三天方案,发现大家都对它有误会
文章链接:https://m.lfdjt.com/p/keji/a/6906.html