2026-10-05 04:12:53
作者:
科技
上周我下楼买奶茶,点开小程序吓一跳。首页顶栏直接推了新品椰乳杨枝甘露,选框里自动填好了「三分糖、少冰、去椰果」。
分毫不差。
我第一次点单填的偏好,它记到现在。
很多人说这就是大数据算的,有什么好稀奇?说实话,要是放在十年前,这种精准度真的做不到。那时候的推荐算法,只能知道你爱喝果茶,就给你堆一堆果茶,根本管不了你爱不爱吃糖、加不加椰果这种细节。
现在能做到,全靠背后那张看不见的网——知识图谱。
你刷到的推荐,不是算法撞大运
别一听“知识”两个字就觉得是学界飘着的概念。其实它一点都不玄乎。
你可以把它理解成一张专门给机器读的关系网。把万事万物拆成两个最基础的部分:节点和连线。节点就是具体的东西,你是节点,杨枝甘露是节点,三分糖是节点,芒果是节点。连线就是它们之间的关系:“XX偏好”、“XX包含”、“XX属于”,所有关系清清楚楚连起来。
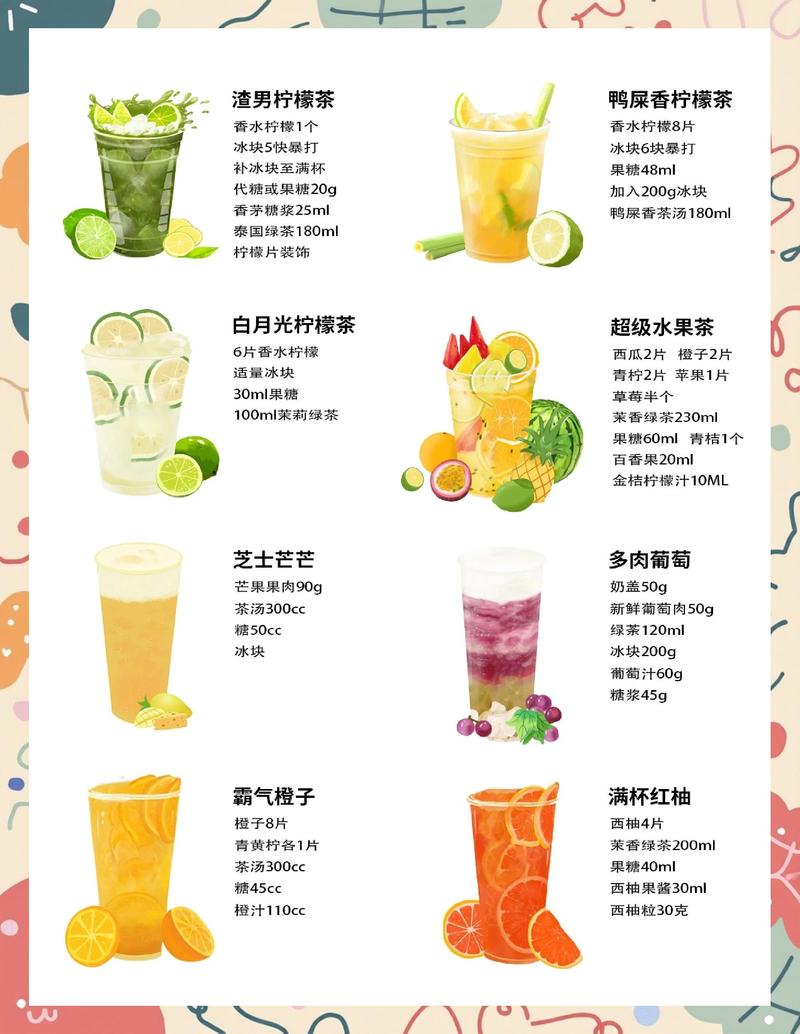 外卖奶茶推荐逻辑知识图谱示意图
传统的推荐算法,是靠统计你的点击数据猜你喜欢,说白了就是碰运气。知识图谱不一样,它真的“懂”你和你点的奶茶之间的关联。
它知道你对芒果不过敏,知道你上次点冰饮是一周前,最近南京气温破了三十度,知道这款新品就是在你常点的杨枝甘露基础上改的,所以才敢直接放到你首页最显眼的位置。
这不是撞大运,是靠关系网推理出来的结果。
不止电商推荐,你用搜索引擎搜“南京有哪些带院子的咖啡馆”,出来的结果直接给你标好地址、营业状态、人均消费,不是搜索引擎突然变聪明了,是它后台的知识图谱已经把这些信息都连好了,不用你点进去一篇一篇找。
别被神话,知识图谱也会“认错人”
现在但凡做点AI的公司,都要吹一吹自己的知识图谱有多厉害,好像有了它就无所不能。其实我见过太多翻车的例子。
上个月我帮朋友查资料,搜“2009年南京玄武湖荷花展”,知识图谱直接给我跳出来2023年的开展时间和门票信息,绑错了节点你敢信?
说白了,知识图谱不会自己长脑子,它的关系都是人或者大模型喂进去的,喂错了,它就错给你看。很多人对它有个误区,觉得知识图谱就是把所有网上的知识堆起来就完事了。根本不是。
捋清楚实体之间的关系,才是最花钱最费功夫的事。同一个名字可能对应好几个实体,比如“玄武湖”,可以是南京的那个湖,也可以是北京的那个公园,还可以是一艘军舰,要是没有做区分,节点混在一起,出来的结果全是错的。
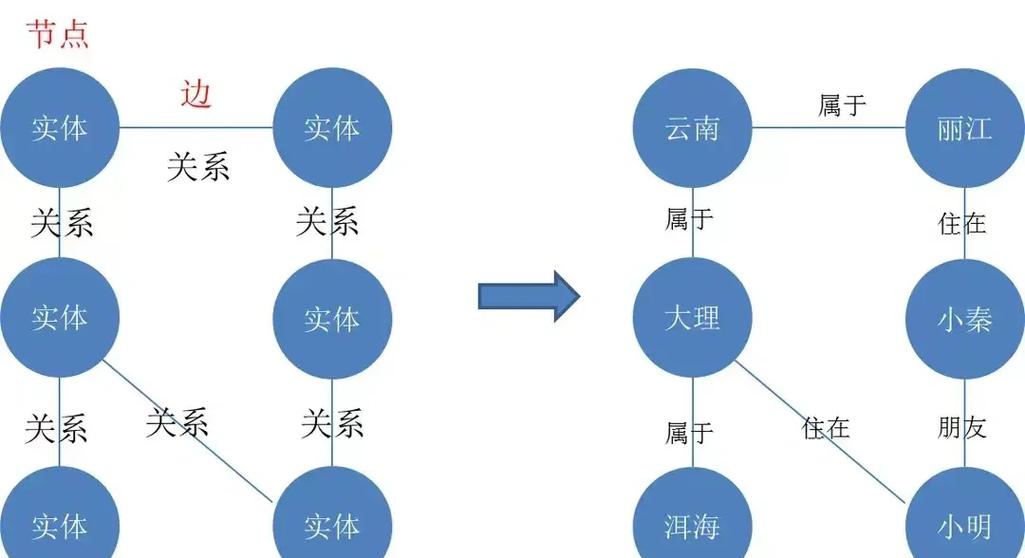 知识图谱实体关系错误连接示例图
我之前跟做算法的朋友聊天,他吐槽说,公司要做一个汽车领域的知识图谱,光梳理“迈腾”这个词的不同年款不同配置,就花了三个工程师半个月的时间。很多中小公司吹自己的知识图谱覆盖多少亿实体,说白了就是爬了点百科数据,把同一个名字的不同实体揉在一起,凑数而已。
真用起来,一搜一个错。
藏在大模型背后的“纠错师”
 藏在大模型背后的“纠错师”
这两年大模型火了,很多人说知识图谱要被淘汰了。我反而觉得,知识图谱的作用才刚刚体现出来。
大模型什么都好,就是爱瞎编。编参考文献,编案例,编不存在的政策,你跟它说理它都能给你圆回来。为什么?因为大模型是靠概率猜下一个字,它不需要知道哪个知识是对的,哪个是错的。
知识图谱刚好补了这个短板。所有存在知识图谱里的内容,都是核对过的确定知识,大模型生成回答的时候,先去知识图谱里搜一遍正确的信息,就不会瞎扯了。
说实话,现在做的好的大模型产品,后台都少不了知识图谱擦屁股。比如医疗问答,你问“板蓝根能不能和布洛芬一起吃”,要是纯大模型回答,可能给你说出好几个错误的结论,要是知识图谱里提前存了权威指南里的配伍禁忌,直接调出来给用户,准确率能升好几个档次。
不过话说回来,知识图谱也离不开大模型。之前做知识图谱,全靠人工标知识,一个月能标几万条就不错了,成本高更新慢,去年出的新热点,今年才能进图谱,根本赶不上变化。现在有了大模型,能自动从新闻、论文、商品描述里挖出实体和关系,自动更新知识图谱,效率翻了不知道多少倍。
一个管产出,一个管对错。刚好互补。
我前阵子见一个做AI创业的人,他说未来的AI,肯定是大模型+知识图谱搭伙干活,大模型当对外的嘴,知识图谱当脑子里的书柜,不会乱说话,也不会跟不上变化。
说的太对了。
下次你点外卖刷推荐的时候,不妨多停两秒。那张看不见的关系网,早把你的那些小偏好,摸得门清了。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:奶茶店的推荐菜单里,藏着你不知道的知识图谱
文章链接:https://m.lfdjt.com/p/keji/a/6584.html