你每天都在受益,只是没听说过它
很多人一听「隐私计算」,第一反应就是高大上的黑科技,跟日常没关系。错了。现在国内主流的互联网平台,做推荐广告、做风控,几乎都在用相关的技术。 早些年不是这样的。早些年你要合作算个结果,就得把自己的数据给对方,或者大家把数据凑到一块存着。等于你要喝一杯牛奶,就得把整头牛牵回自己家,太危险了。哪怕你说我用完就删,谁能保证中间不会被偷?谁能保证你不会偷偷留一份?前几年多少数据泄露事件,都是这么来的。 隐私计算解决的就是这个问题。说白了,它的核心逻辑就是一句话:数据不动,计算动。数据本来存在哪,就一直待在哪,我只把要算什么的任务拆了,送到你这边算一点,送到他那边算一点,最后只把拼起来的结果拿出来,没人能碰得到别人的原始数据。 举个最直观的例子,我和你手里各有一半用户的消费数据,现在我们想一起算出来「25到30岁女性最爱买什么」,放在以前,我俩得把各自的用户数据交换,凑一起排序才能出结果,交换的过程就是泄露。现在用隐私计算,我的数据还在我这,你的还在你那,计算过程在两边分别跑,最后只出来「最爱买口红和面膜」这个结果,我看不到你的用户信息,你也看不到我的。
别被术语吓住,几个误区得掰明白
每次讲新科技,最怕的就是一堆术语堆过来,什么安全多方计算、联邦学习、可信执行环境,看完直接劝退。其实不用记这些名词,你只要掰明白几个常见误区就行。 第一个误区:很多人说隐私计算就是给数据加密,换汤不换药。不对。加密是把你的数据锁进箱子,钥匙给你,要用的时候得开箱拿出来。隐私计算是你锁着箱子,我直接隔着箱子算你箱子里数据的结果,全程不用开箱,钥匙从来都在你手里。区别大了去了。 第二个误区:隐私计算能100%保证隐私不泄露。这话谁跟你说谁就是在骗你。说实话,没有任何一种技术能做到绝对安全。之前业内也出过论文,说可以通过计算结果倒推出来原始数据的部分信息,只是这种攻击成本很高,日常场景下根本不会碰到,比裸奔强一万倍,但绝对不是万能锁。 第三个误区:隐私计算就是互联网公司用来赚噱头的。也不对,很多传统领域用的比互联网还积极。比如医院,之前想做多中心的药物临床试验,各个医院的病人数据根本不能随便往外拿,合规风险大到吓死个人,攒个数据要三五年,现在用隐私计算,各个医院在本地算,最后汇总结果,一年多就能跑下来,还不碰病人隐私。再比如银行,想给小微企业批贷款,只看自己的客户数据不够,还要看水电煤的缴费数据,以前要拿数据得走一堆审批,现在直接用隐私计算算,不用挪数据就能出授信结果,效率翻好多倍。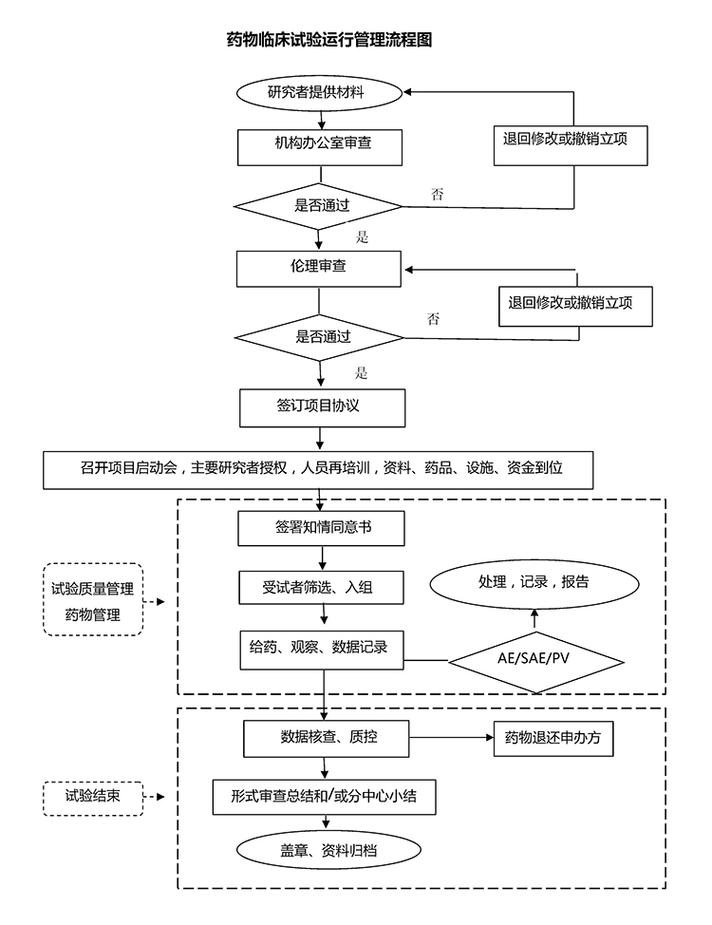
概念火了好几年,还有好几个坎没过去
作者|科技
排版|科技
审核|见微