2026-09-28 09:16:59 分类:正文
去年9月23号在南京国展中心逛科技展,人挤得连空调风都吹不透,我绕开喊着“大模型一键生成”的展台,挤到最偏僻的东北角,撞见一块半人高的芯片展示板,上面印着密密麻麻像神经元突触一样的银灰色纹路。
讲解员凑过来开口第一句就把我留住了:“这不是给大模型加速的普通AI芯片,这是做类脑计算的。”
我站那听了十分钟,大半术语都没记住,就记住一句话:现在我们用的AI,是堆算力“算出来的智能”,这个东西,是照着人脑长出来的智能。真的挺震撼。
我们现在的AI,到底卡在哪了?
现在的大模型多厉害啊,写文案画图改代码,样样都行。可你让它估一下,刚倒在保温杯里的开水,多久能降到能入口的温度?它大概率会给你套一堆热传递公式,算出来一个差十万八千里的数。换个正常人,摸一下杯子外壁,大概就知道还要等几分钟,根本不用算公式。
为啥?因为人不靠死记硬背公式,靠的是千万次经验攒出来的感知,是神经元网络自然出来的结果。
说实话,现在大模型越做越大,能源消耗已经离谱到没法看了。训练一次超大规模大模型,耗的电够一个小县城用小半年,日常跑推理的电费,很多小公司都掏不起。这个一路堆参数堆算力的路子,真的能一直走下去吗?
我们现在用的所有芯片,不管多先进,根子上还是冯诺依曼架构,存储和计算是分开的。你要算个东西,就得把数据从存数据的地方搬到计算单元,搬来搬去,时间和电都耗在这路上了。
人脑就不这样。人脑的每个神经元,自己既存记忆,又做计算,压根不用来回搬数据。这就是类脑计算最开始的思路:照着人脑的工作方式,做一套全新的计算架构。
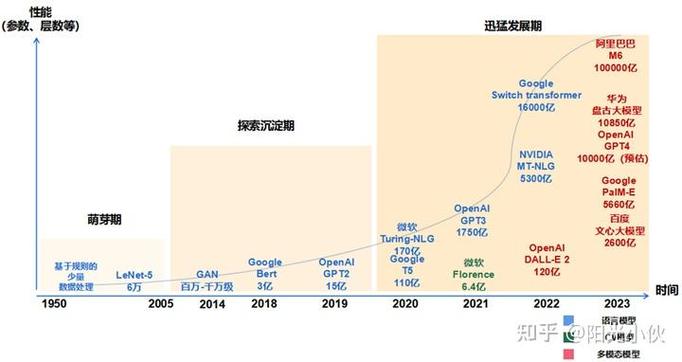 传统大模型与类脑芯片功耗对比柱状图
很多人对类脑计算的第一理解,就是错的
刷到过不少科普,一讲类脑计算就说“我们要复刻整个人脑,八百亿个神经元全部做出来”,然后算出要多少多少材料多少电,说一百年也做不出来。
这完全是误区。
现在做类脑计算,根本不是要一比一克隆人脑,只是复刻人脑“存储计算一体”“脉冲激活”的工作逻辑,规模大小按需来就行。你做一块给智能手表用的类脑芯片,几千几万个神经元就够了,干嘛要做八百亿?
而且它天然就适合处理那种模糊的、缺一块的信息。就比方说你走在街上,远远看见一个人半个身子被电线杆挡住了,你一眼就能认出来那是个人。换传统AI,如果训练数据里这种半遮的人不多,它大概率认错。类脑计算不会,它是靠整个神经元网络的激活模式来识别的,缺一块,整体模式还在,就能认对。
我之前看过一个公开测试,同样做动态障碍物识别,类脑芯片的功耗只有传统AI芯片的不到百分之一。就这么点电,就能干活,你说香不香?
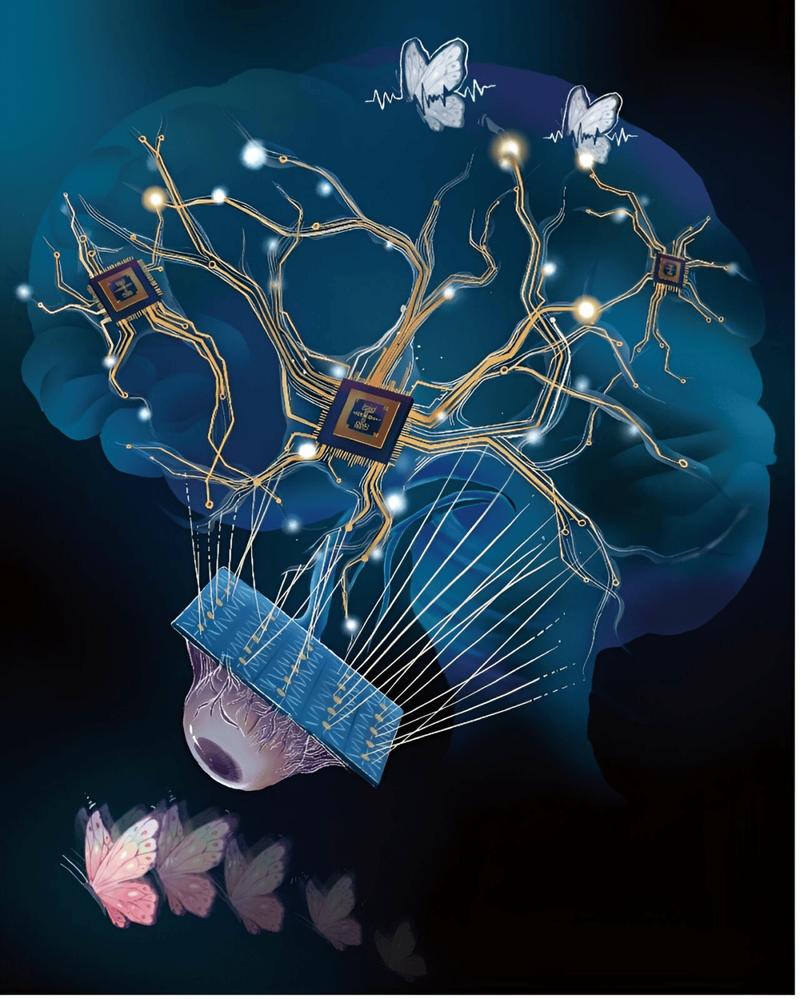 类脑计算人工突触芯片显微实拍图
不过话说回来,现在很多营销号吹类脑计算能马上超越大模型,那纯纯是炒概念。现在最大的类脑芯片,突触数量也就亿级,和人脑的百万亿级比,差了好多个数量级,你让它写一篇十万字的小说,它现在根本做不到。
类脑计算的价值,根本不是抢大模型的饭碗
 类脑计算的价值,根本不是抢大模型的饭碗
很多人一说起新技术,就爱问“它能不能干掉旧技术?”其实很多时候,新技术是给你开了一条全新的路,不是来抢路的。
类脑计算现在已经在很多场景落地了,不是遥不可及的概念。就比如低功耗的边缘设备:智能手表要实时监测心率异常,无人机要在树林里实时避障,工业传感器要识别异常振动,这些场景都不需要大模型那样的大算力,就需要又快又省电,能实时处理,这不就是类脑计算最擅长的吗?
之前我看到过一个国内团队做的类脑无人机,在杂乱的果林里飞,绕开树枝采摘果实,反应速度比传统芯片快了十倍,还不用把数据传到云端,完全在本地处理,隐私性还好。这不就是实实在在的进步吗?
我们这么多年做人工智能,其实一直陷入一个怪圈:觉得智能就是会做逻辑题,会写文章,会考试,所以堆算力堆参数,往越来越大的方向走。可生物演化了这么久,最核心的智能其实是“适应环境”,是用最少的能量,处理最复杂的不确定的信息,这恰恰是我们现在的AI做不好的地方。
类脑计算就是从这个最基础的地方开始,重新出发。它不一定能造出比大模型更强的通用AI,可它给我们指了另一个方向:原来智能不一定是堆出来的,还可以是长出来的。
那天从展出来,我在新街口附近找了个小店吃鸭血粉丝汤,吹着空调,脑子里还想着那块展示板上的突触纹路,像一片缩小的森林,每一条纹路都留着变化的空间,等着新的信号进来,长出新的连接。
谁知道那片森林里,以后会长出什么不一样的东西呢。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:类脑计算:为什么说它可能不是AI的下一站,而是另一条路?
文章链接:https://m.lfdjt.com/p/keji/a/4143.html