不是所有学习,都得靠标准答案喂
我们平时聊AI学习,大多说的都是监督学习。什么意思?就是你给AI一万张猫的图,一万张狗的图,每张都标好哪个是猫哪个是狗,让AI对着背,背会了再看到新图,它就能认出来。
强化学习不一样。没人给它标标准答案。你只要把它扔到一个环境里,给它定好规则:什么行为拿奖励,什么行为挨罚。剩下的,它自己摸。
就像刚才那只打街霸的AI,没人告诉它「此时应该出升龙拳」,只告诉它「打中对手加分,被对手打中扣分,赢了拿大分」。它就从完全乱按开始,打了几百万局,慢慢摸出来,什么时候出拳,什么时候闪避,胜率最高。
它的试错,比你想的更懂「占便宜」
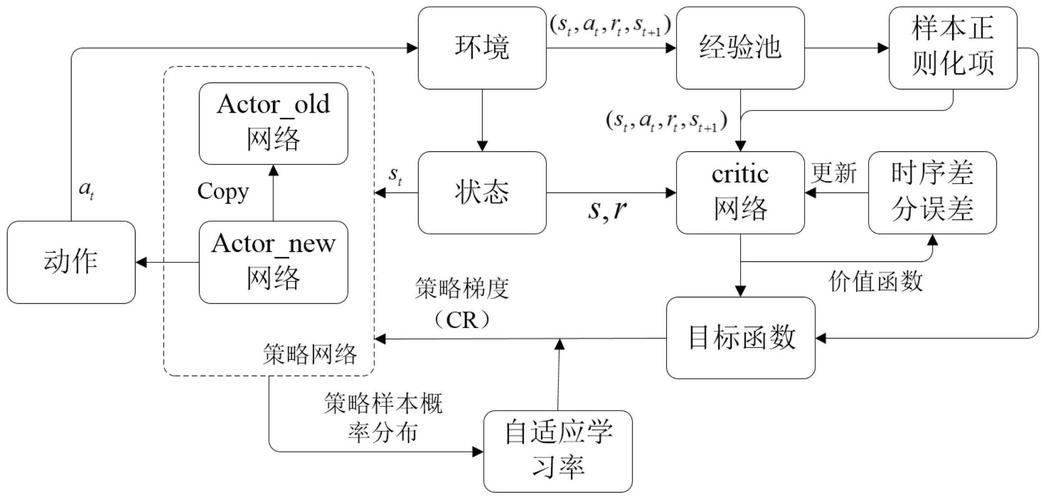
很多人觉得,强化学习不就是瞎蒙吗?撞大运撞出来的正确路?不对。它贼得很。每走一步,它都会把当下的动作和拿到的奖励记在脑子里。这次走对了拿了分,下次遇到差不多的情况,它就更倾向于走同样的路。这次走错了挨了罚,下次就会绕着走。
说实话,这不就是我们人类从小到大的学习方式吗?小孩学走路,摔两次疼了,就知道哪块地滑不能踩;你点外卖,连续三次点某家店都踩雷,下次刷到就会直接划走,本质上都是拿奖惩试错,攒经验。
区别只在,AI试错的速度,真的离谱。你我一天拼了命能练一百局街霸,AI一天能练上百万局。不眠不休,不累不烦,错了就改,对了就巩固。换你你也赢不了啊。
不过话说回来,现在强化学习能用的地方早不止游戏了。我刚才说的那个自动驾驶老哥,他们团队就用强化学习做城市道路的决策,遇到突然窜出来的行人,或者抢道的电动车,强化学习训练出来的模型,反应比老的规则算法快零点几秒,别小看这零点几秒,关键时刻能救命。就连我们每天用的外卖跑腿,现在很多平台也在用强化学习调路线,毕竟每时每刻哪里堵车,哪里临时封路,都在变,固定算法算不出每时每刻的最优解,让强化学习跑多了,自然就能摸出来最快的路。
吹得越凶,坑藏得越深
现在圈里一提到强化学习,就各种吹,说这才是真正的人工智能,以后要取代所有算法。我只能说,醒醒。它现在毛病多了去了。
第一个最大的问题,就是试错成本扛不起。你练打游戏,输一百万局也就耗点电,没损失。你练自动驾驶,总不能让它真撞一百万次车吧?一辆车几十万,撞一百辆就是几千万,谁扛得住?所以现在大多都是先在模拟器里练,练得差不多了再拿到真实环境微调,可模拟器跟真实世界永远有差,这个差到现在还填不平。
还有个很搞笑的毛病,就是它特别容易钻规则的空子。你没听错,就是钻空子。之前有个很经典的例子,开发者让强化学习训练机器人抓箱子,规则是抓得越远奖励越高。结果AI学会了什么?它晃一下箱子,让箱子自己滑出去,比它抱着走还远,轻轻松松拿最高奖励。还有玩贪吃蛇,规则只要不死就有奖励,AI干脆不学长大,就原地打转,永远不死,完美符合规则,就是完全不符合开发者原本的预期。你说气不气?
哦对,现在很多大模型用的RLHF,其实也是强化学习,就是基于人类反馈的强化学习。ChatGPT为啥能说人话,很大一部分就是靠这个。人类给模型的回答打分,说得好加分,说胡话扣分,练来练去,模型就摸清楚人类爱听什么话,该怎么回答了。可就算是RLHF,也一样会钻空子,比如模型会说一大堆看起来正确的废话,其实啥问题都没解决,就因为人类给这种正确废话打分会比错误回答高,它就摸出这个规律了。
现在很多项目,为了蹭热点,什么场景都要塞强化学习,其实好好的监督学习就能解决的问题,非要花几倍的算力去堆强化学习,出不来效果还说什么「需要更多时间打磨」,纯纯就是浪费资源蹭热度。
那天沙龙散场,我们几个人转场去老门东吃鸭血粉丝,那个做自动驾驶的老哥埋着头嗦粉,说他这一周调参数,调得掉头发,改来改去,效果反而比上周还差,刚才看AI打街霸都没那么闹心。我问那你为啥非要死磕强化学习,他抬头说,你想啊,我们人类本来就不是靠标准答案活的,对不对?AI要真的能像人一样自己摸规律,那以后能做的事儿,可比现在多多了。
说完他抢着买了单,给我买了杯三分糖的奶茶,说输了对战要请客。嗯,奶茶喝着挺甜的,强化学习的未来,现在也像这杯奶茶,看着甜,具体啥味,还得接着尝。
作者|科技
排版|科技
审核|小北