上周三挤了半小时地铁到南京栖霞的那栋实验室楼,进门被保安拦着查了三次访客码。同行的研究员拎着半袋刚从园里摘的橘子,说前两天下雨挂的果,甜得很,转头就把我带进了恒温恒湿的超净间。
推开门的时候我第一反应是,这里和我想象里堆满服务器的AI实验室完全不一样。没有嗡嗡响的散热风扇,只有几台摆在操作台上的显微镜,还有一块巴掌大的开发板,亮着淡蓝色的小灯。
现在的大模型,本质是在做”暴力算数”
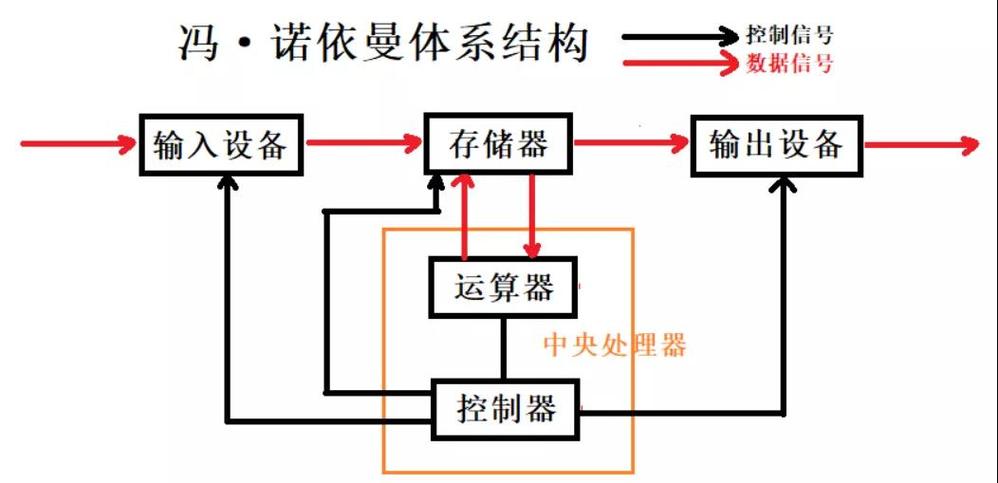
现在我们手里所有的电脑、手机、甚至跑大模型的GPU,本质上都还是沿着70多年前冯诺依曼定下的框架走的——计算单元和存储单元是分开的,每次要算东西,都得先把数据从存储的地方搬到计算的地方,算完再搬回去,整个过程里,真正用来算数的时间可能连十分之一都不到,剩下的全浪费在来回跑数据的路上了。
太浪费了。
尤其是现在跑大模型的时候,你哪怕只是问一句”今天中午吃什么”,背后也要把整个模型的上百亿甚至上千亿参数全部过一遍,数据在内存和计算核心之间来回跑,耗电极高,散热成本也居高不下。存算分离带来的能耗瓶颈,已经是整个AI行业绕不开的坎。之前看到公开的测算数据,一次千亿参数大模型的推理能耗,能抵得上普通家庭好几天的用电,这还不算训练的时候烧的电费。
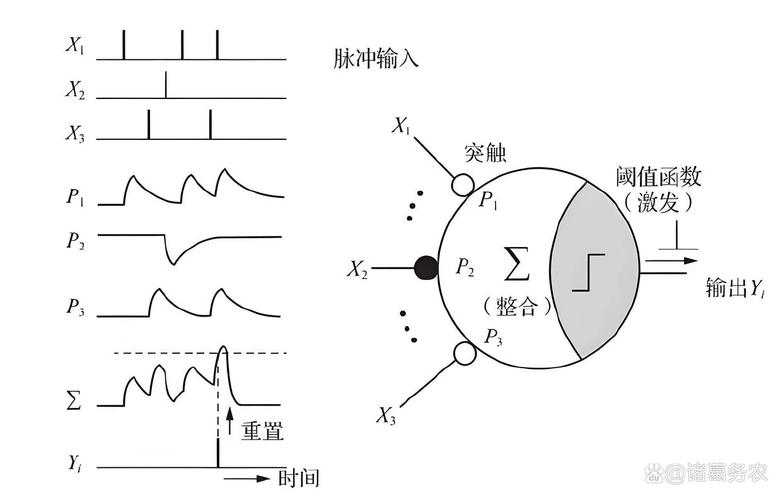
研究员当时给我指了指操作台上那块指甲盖大的芯片,说这就是他们做了快六年的类脑芯片。上面的每一个单元,都模拟了生物神经元的工作逻辑——没有信号的时候就安安静静待着,只有收到符合阈值的输入,才会发一个短短的脉冲信号出去。
他当时把开发板接上一个普通的USB摄像头,对着我手里拎的那袋橘子拍了一下,旁边的小屏幕立刻跳出”柑橘类水果”的识别结果。整个过程没有接外接电源,靠开发板上的纽扣电池已经跑了快两个小时。我凑过去摸了摸芯片,凉的,一点温度都没有。要是同等算力的GPU跑这个识别,早就烫得能煎鸡蛋了。
类脑计算不是”造人工大脑”,别搞混了
说实话,我之前刷到过不少营销号写类脑计算的内容,什么”要造出能产生意识的人工大脑””三年取代大模型”,看得我当场把手机塞回口袋。
真不是那回事。类脑计算抄的是大脑的”节能逻辑”,不是要复刻意识。人类的大脑总共也就140亿个神经元,满负荷运转的功耗才20瓦左右,相当于一个家用节能灯泡的功率,还能同时处理视觉、听觉、语言、运动控制这么多任务,核心就是刚才说的——不用全脑激活,只有用到的那一小部分神经元才会工作,没活的时候绝对不瞎耗电,对吧?
说穿了就是个”懒鬼逻辑”。
现在的类脑芯片,模拟的就是这套懒鬼逻辑。它不会像传统芯片那样一直跑着满负荷的电平输出,而是只有当输入的信号达到特定阈值的时候,才会产生一个脉冲传给下一个单元,大部分时间都处在低功耗的待机状态。
它现在能干的事其实特别实在。比如装在野外的地震传感器里,之前的传感器要把采集到的所有震动数据都传到几百公里外的云服务器上算,不仅耗电大,遇到断网的时候还会丢数据。换成类脑芯片的话,直接在传感器本地就能把风吹草动、动物跑过的无效数据全部筛掉,只有真正达到地震级别的震动出现时,才会发一个警报信号出去,一颗纽扣电池就能用五六年。

还有现在大家戴的智能手表,之前要24小时监测心率、睡眠,用不了一天就得充电。换成类脑芯片做本地计算的话,能连续用两三个月不用插电,也不用把所有的健康数据都传到云端,隐私性还好。
现在的类脑计算,还在”学走路”的阶段
那天我剥了个橘子,问那个拎橘子的研究员,”你们做这个,会不会哪天就被大模型的发展给碾过去了?”
他当时把橘子籽吐到旁边的回收盒里,说”不会啊。大模型是在已经搭好的冯诺依曼的架子上跑,我们是在搭另一个架子。以后说不定大模型的推理部分,就会用到类脑的芯片,不然现在跑一次大模型的电费都快付不起了。”
话是这么说,但现在的类脑计算确实还在很早期的阶段。我们现在对大脑本身的理解就还没到顶——比如神经元之间的连接到底是怎么编码复杂信息的,情绪、创造力这些东西到底是怎么从神经元的脉冲里冒出来的,现在很多都还是假说,不是实锤。
所以现在的类脑芯片,模拟的只是我们已经摸清楚的那部分最基础的神经元逻辑,就像你只看了一本武功秘籍的第一页,就想复刻整个招式,肯定有差距。比如他们实验室之前做过测试,让类脑芯片识别10种常见的花卉照片,在背景干净的情况下准确率能到95%,但要是换成背景杂乱、角度刁钻的实拍图,准确率直接掉一半,泛化能力和现在的大模型比起来差得远。
我临走的时候他塞给我半袋橘子,说下次来要是能看到芯片集成到上亿个神经元单元,就能给我演示个更有意思的东西——比如让它实时识别路边的行人和车辆,还不用接外接电源,装在普通的监控摄像头里就能跑。
坐地铁回去的时候我一直在想,其实我们对技术的想象总是太急了。总想着今天出个概念,明天就要颠覆世界。
但类脑计算这种东西,本来就是要蹲在实验室里,一点点抠出来的。
毕竟大脑自己都花了几百万年才进化成现在的样子,我们哪能三五年就全抄完啊。
作者|科技
排版|科技
审核|满满